Frontiers | Çok Modlu Girişlerle Duygu Bilgili Sahte Ses Tespiti için Geliştirilmiş FusionNet Derin Öğrenme Yapısı
VIT-AP Üniversitesi, Bilgisayar Bilimi ve Mühendisliği Fakültesi, Amaravati, Andhra Pradesh, Hindistan Ses tabanlı deepfake'ler, ses tabanlı sistemler…
ÖZGEL ŞEKİLDE YAPILAN ARAŞTIRMA makalesi
Front. Artif. Intell., 13 Kasım 2026
Sek. Makine Öğrenimi
Cilt 9 – 2026 | https://doi.org/10.3389/frai.2026.1978052
- BA
Bhargavi Anumula
- AV
Anil V. Turukmane *
-
VIT-AP Üniversitesi, Bilgisayar Bilimi ve Mühendisliği Fakültesi, Amaravati, Andhra Pradesh, Hindistan
Makale ölçütleri
Özet
Ses tabanlı deepfake’ler, ses tabanlı sistemler için önemli bir güvenlik riski oluşturmakta ve gerçek ile sentetik konuşmayı ayırt etmek için etkili yöntemler gerektirmektedir. Bu çalışma, Log-Mel tabanlı akustik temsilleri MultiScaleCNN, İki Yönlü Kısa-Uzun Süreli Bellek (BiLSTM), Çok Başlı Çapraz Dikkat, Kalıntı Özellik Birleştirmesi ve Uyarlanabilir Kapalı Birleştirmele birleştiren, deepfake konuşma tespiti için duygudurum-duyarlı bir derin öğrenme çerçevesi olan Enhanced FusionNet’i sunmaktadır. Duygudurum temsili, konuşmacıdan bağımsız bir duygudurum kodlayıcı kullanılarak RAVDESS veri kümesinden ayrı ayrı öğrenilmekte ve ardından FoR tabanlı deepfake tespit çerçevesine aktarılmaktadır. Bağımsız FoR ayırma test kümesinde Enhanced FusionNet %98,67 doğruluk, %98,18 kesinlik, %99,17 geri çağırma, %98,67 F1 skoru ve %99,88 ROC-AUC elde etmiştir. Beş katlı çapraz doğrulama, %99,08 ± 0,35 ortalamalı doğruluk ve %99,94 ± 0,05 ROC-AUC üretmiştir. Model, katman dışı değerlendirmede %99,40 duyarlılık, %98,75 özgüllük ve %0,91 EER (eşit hata oranı) daha elde etmiştir. Bileşen düzeyinde ablation analizi, mimari bileşenlerin değişken katkılarını gösterirken, kontrollü yalnızca FoR ile FoR + Duygudurum deneyi, aktarılan duygudurum temsilinin tamamlayıcı bilgi sağladığını ancak değerlendirilen protokolle genel tespit performansını iyileştirmediğini ortaya koymuştur. Bulgular, Enhanced FusionNet’in değerlendirilen temel koşullar altında etkinliğini gösterirken, aynı zamanda veri kümesi dışı çapraz ve görülmemiş üretim değerlendirmesi için gereken önemi de vurgulamaktadır. Gelecek çalışmalar, çok dilli ve alanlar arası değerlendirme, güncel anti-spoofing temel yöntemleri, görülmemiş sentetik yöntemler ve gerçek zamanlı kullanım için hesaplama verimli varyantlara odaklanacaktır.
1 Giriş
Dijital dönüşümün, bireylerin ve şirketlerin gizli verileri nasıl koruduğu üzerinde önemli bir etkisi olmuştur. Bu bağlamda ses biyometrik kimlik doğrulama, tabanlı bilgi (PIN’ler, parolalar) ve tabanlı anahtar (akıllı kartlar, OTP’ler) gibi geleneksel güvenlik önlemlerine çekici bir alternatif haline gelmiştir (Univaso ve San Segundo, 2025). Sabit kimlik doğrulamalar (parolalar, PIN’ler, kimlik kartları vb.) hırsızlığa, kötüye kullanıma veya insan sesinin benzersiz fizyolojik ve davranışsal özelliklerinden yararlanılarak yapılma riskine sahiptir; insan sesinin bu benzersiz fizyolojik ve davranışsal özelliklerinden yararlanılan ve ses biyometrik olarak bilinen bir yöntemdir (Ma ve ark., 2024). Ayrıca konuşma biyometrikleri invaziv değildir; bu nedenle kolay erişim sağlanır ve son kullanıcıların daha az çaba harcamasını gerektirir, bu da mevcut sahte konuşma tespit sistemlerinde ciddi bir dezavantaj olarak bulunmuştur (Sim ve Islam, 2026). Kurumların dijital platformları kullanımı yönündeki artan eğilimle birlikte, güvenli, güvenilir ve kolay erişilebilir protokoller oluşturmaya yönelik ihtiyaç artmıştır. Ses kimlik doğrulama, doğal ve sezgisel bir arayüz teşvik ederek parola hatırlatma ve/veya kaybolan, unutan veya hırsızlanan fiziksel anahtarlar taşıma ihtiyacını en aza indirir (Morrison ve Enzinger, 2016). Ses biyometrikleri, ses tabanlı kimlik doğrulama yoluyla güvenliği güçlendirmek ve müşteri deneyimini iyileştirmek amacıyla temas merkezleri ortamlarında da incelenmiştir (Arcot ve ark., 2025).
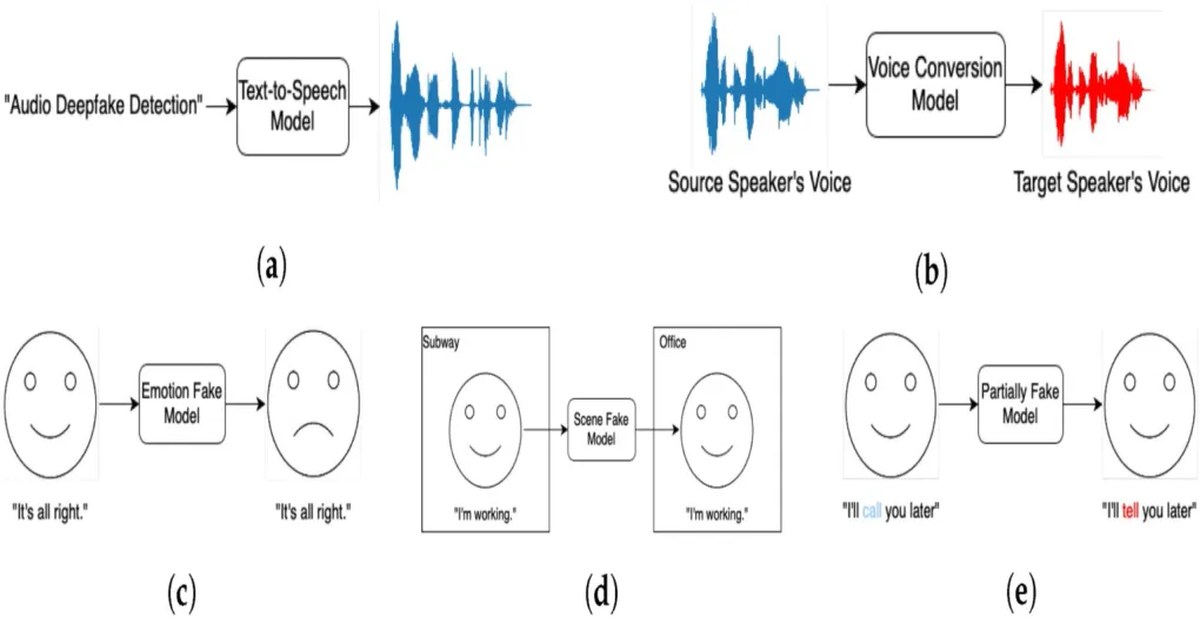
Finans teknolojisi gibi yüksek güvenlikli ortamlarda, ses tabanlı kimlik doğrulamanın tüketicilerin kimliğinin doğrulanması, bakiyelerinin kontrolü ve sesli ödemelerin yapılması gibi çeşitli görevlerin yerine getirilmesinde yaygınlaşmasıyla önemi öne çıkacaktır (Morrison ve Enzinger, 2016). Sağlık alanında ses arayüzleri, anlık kimlik doğrulamanın pratik olmadığı veya erişilebilir olmadığı uzaktan izleme sistemleri, tele-tıp uygulamaları ve yaşlı bakımı için ev arayüzlerine uyarlanmaktadır (Ye ve ark., 2025). Ses biyometrisi aynı zamanda nesnelerin yönetimi, ev güvenliği ve kişisel asistan uygulamaları için sesli komutların kullanıldığı akıllı evlerde ve Nesnelerin İnterneti’nde kritik bir standart haline gelmektedir; ses tanıma, güncel herkes-ekosistemlerinde en çok kullanılan modaalitelerden biridir (Ogenyi ve ark., 2025). Ses sistemleri, güvenlik, kolaylık ve entegrasyon esnekliği sayesinde bir sonraki nesil dijital kimlik yönetiminin yapı taşları olacaktır. Şekil 1’de önemli ses tabanlı sahte içerik üretimi ve manipülasyon yöntemlerini sunmaktayız. Bunlardan bazıları metinden ses üretimi yapan Metinden Sese modelleri, konuşmacının sesini değiştiren Ses Dönüşümü modelleri, mesajın içeriğini değiştirmeden konuşmanın duygusal durumunu değiştiren Duygusal Manipülasyon modelleri, konuşmanın arka plan bağlamını değiştiren ancak mesajın içeriğini değiştirmeyen Sahne Manipülasyon modelleri ve konuşmanın özgün üslubunu değiştirmeden orijinal konuşmanın bireysel kelimelerini veya ifadelerini değiştiren Kısmi Manipülasyon modelleridir. Ses tabanlı sistemlerin önemli özelliklerinden biri, yalnızca konuşmacının kimliğinin değil, aynı zamanda konuşmacının tonlama, konuşma üslubu ve duygusal durumu gibi paralinguistik özelliklerinin de yakalanmasıdır (Wu ve ark., 2020). Bu, yalnızca kimin konuştuğunu değil, aynı zamanda nasıl konuştuğunu da anlama, biyometrik alana derinlik katmakta ve kimlik doğrulamayı insanların doğal iletişim kurma biçimine yaklaştırmaktadır (Janeja, 2022). Benzer şekilde, Nesnelerin İnterneti’nde akıllı ev güvenliğini artırmak amacıyla K-en yakın komşu
komşu (KNN) (Jadhav ve Manakhari, 2024).
Şekil 1
İnsanların yalanı veya tutarsızlıkları tespit etmek için kullandığı konuşma ayrıntıları, güvenlik alanını desteklemek amacıyla hesaplama modellerine dahil edilmektedir. Göz önünde bulundurulması gereken bir diğer kavram ise bireylerin Amazon Alexa, Apple Siri ve Google Assistant gibi yapay zekâ ile çalışan sesli asistanları ne kadar hızlı kullandığıdır. Bu durum, devasa miktarlarda konuşma verisinin toplanmasını, saklanmasını ve paylaşılmasını mümkün kılmaktadır (Variani et al., 2014). Bu yaygınlık, karşılığında daha fazla esneklik ve kullanım kolaylığı sağlasa da, saldırganlar için makul düzeyde bir saldırı yüzeyinin genişlemesini de beraberinde getirmekte ve biyometrik ile siber güvenlik araştırmalarında güvenlik değerlendirmelerini zorunlu kılmaktadır (Panayotov et al., 2015). Daha uzak bir iş gücü, görüntülü konferans çevrimiçi işlemlerle birleşince, konuşma verisinin gizliliğinin, bütünlüğünün ve doğruluğunun güvence altına alınması önem kazanmaktadır. Son yıllarda, konuşma sentezi ve üretici modellemede kayda değer ilerlemeler kaydedilmiş ve bu gelişmeler önemli bir saldırgan aracının ortaya çıkmasına yol açmıştır: ses tabanlı sahtecilik (voice deepfake) (Masood et al., 2023). Konuşma deepfakes’i, Üretici Savaş Ağları (GAN’lar), WaveNet gibi otoregresif modeller ve difüzyon tabanlı Metinden Ses’e (TTS) yönelik modeller dahil olmak üzere gelişmiş makine öğrenmesi modelleri kullanılarak üretilmektedir. Günümüzde, gerçek sese o kadar yakın bir sahtecilik oluşturmak mümkün ki, bu kimseyi alayabilir. Bugün bir sahtecilik, önceki metinden-ses’e yönelik, robotimsi prosodi ve hatalı tını temelli teknolojiye kıyasla daha yüksek ses sadakatine sahip olması nedeniyle, bir kişinin doğal sesine tını, aksan, prosodik varyasyon ve hatta konuşma hızı açısından daha önce hiç olmadığı kadar yakın görünebilir (Kumar et al., 2019). Jia et al. (2018), konuşma üretiminde konuşmacı temsillerinin potansiyelini vurgulayan, konuşmacı doğrulamasından çoklu konuşmacılı metinden-ses’e senteze aktarımlı öğrenme kullanımını göstermiştir. Ses tabanlı sistemlerde doğrulama, sentetik seslerin hem insanları hem de makineleri alatabilmesi nedeniyle daha az güvenilirdir (Zhang et al., 2026).
Bu teknoloji yaratıcı alanlarda, kişiselleştirilmiş dijital asistanlarda, çok dilli seslendirmede ve konuşmada zorlanan kişilere destek olmak amacıyla değerlendirilebilir. Ancak silah olarak kullanıldığında, ses tabanlı dolandırıcılık (vishing) saldırıları, kurumsal sahtekârlık, ses tabanlı sözleşmelerden yararlanma ve bir acil durumda birini taklit etme gibi sonuçlara yol açabilir (Li ve ark., 2020). Daha da kötüsü, deepfake oluşturmak için erişilebilir birçok açık kaynaklı araç bulunmaktadır ve bu da kötü niyetlilerin sisteme girmesini kolaylaştırıyor. Bu durum, stu’nun kendimizi korumak için acilen yeni yöntemler bulması gerektiğini gösteriyor. Bu nedenle, güncel ses kimlik doğrulama araştırmalarının odağı; spektral ve akustik özelliklerin ötesinde, duygusal tutarlılık, prosodik düzensizlikler ve dil işaretleri gibi sesin davranışsal, duygusal ve bilişsel yönlerini de yansıtan tespit sistemlerinin geliştirilmesine yöneliktir (Wu ve ark., 2020; Janeja, 2022).
Bu çalışmada, ses tabanlı biyometrik kimlik doğrulamaya yönelik, hem sesin özgünlüğünü hem de duygusal özellikleri kullanan sağlam bir deepfake ses tespit çerçevesi önerilmektedir. Önerilen Enhanced FusionNet; Log-Mel spektrogram tabanlı akustik özellik çıkarma, MultiScaleCNN, BiLSTM, Multi-Head Cross-Attention, Artırılmış Özellik Birleştirme (Residual Feature Fusion) ve Uyarlanabilir Kapalı Birleştirme (Adaptive Gated Fusion) bileşenlerini birleştirerek ayırt edici mekânsal ve zamansal temsili öğrenen bir birleştirme ağıdır. Çerçeve, FoR ve RAVDESS veri setleri üzerinde bağımsız hold-out test, 5 katlı çapraz doğrulama, istatistiksel anlamlılık analizi, ablasyon çalışmaları ve hesaplama karmaşıklığı analizi ile değerlendirilmektedir. Önerilen çözüm, gelecekteki ses tabanlı biyometrik deepfake ses tespit sistemlerinin güvenliğini artırmaya katkıda bulunabilecek etkili ve güvenilir bir çözümdür.
2 Literatür taraması
2.1 Ses biyometrisi: güvenlik potansiyeli ve ortaya çıkan tehditler
Gupta ve ark. (2024), ses tanımanın bireyin sesinin yükseklik, ses rengi ve artikülasyon gibi kendine özgü özelliklerine dayandığı için şifreden daha zor sahteciliğe uğratılabileceğini belirterek kimlik doğrulama sürecinin güvenliğini artırmak için ASV’nin kullanılabileceğini öne sürdü. (Li ve ark., 2025), konuşma sentezleme ve ses dönüştürme teknolojilerinde kaydedilen ilerlemelerin, geleneksel ASV sistemleriyle gerçek konuşma ile sahte ses arasındaki farkı ayırt etmeyi giderek zorlaştırdığını belirtti. (Yan ve Liu, 2024) ayrıca, saldırganların hedef konuşmanın yalnızca birkaç dakikasını yakalayarak bir konuşmacıyı klonlayabileceğini, böylece son derece gerçekçi konuşma taklidi yapabileceğini ve dolandırıcılık ile kimlik hırsızlığı olasılığını önemli ölçüde artırabileceğini gösterdi.
Liu ve ark. (2022), güncel derin öğrenme sistemlerinden çıkan yüksek kaliteli sentez konuşmanın, geleneksel ASV sistemleri için önemli bir meydan okuma oluşturduğunu savundu. (Das, 2021), veri artırma stratejilerinin, konuşma sahtecilik karşıtı sistemlerinin çeşitli sahtecilik saldırılarına karşı dayanıklılığını önemli ölçüde artırdığını ve tespit performansını temel modellere göre iyileştirdiğini gösterdi. Benzer şekilde, (Li ve ark., 2025), ileri sahtecilik saldırılarına karşı tespit doğruluğunu artırmak için geleceğin sahtespot tespit sistemlerinin tamamlayıcı konuşma akustik, zaman ve davranışsal özelliklerini kullanması gerektiğini belirtti.
2.2 Sahtespot tespit: teknikler ve sınırlamalar
Shin ve ark. (2023), derin tespit algoritmalarının MFCC’ler, CQCC’ler ve LPC gibi el ile tasarlanmış akustik özelliklere dayandığını, bunun eski nesil sentez konuşmayı doğru şekilde tespit edebildiğini ancak üretken konuşma modellerinin yeni neslinin doğru şekilde tespit edilemediğini belirtti. (Conti ve Pompili, 2022) ile (Hosler ve Wang, 2021a) ayrıca, Üretici Karşıtı Ağlar, WaveNet ve Yayılım Modellerine dayanan konuşma sentezleme yöntemlerindeki son ilerlemenin, spektral artefaktların varlığını büyük ölçüde azaltarak, geleneksel konuşma tespit yöntemlerinin kullanımını sınırladığını belirtti.
Bu sorunları çözmek amacıyla (Javed ve ark., 2022) ile (Yi ve ark., 2023), deepfake konuşma tespitinin sağlamlığını ve tespit performansını artırmak için gelişmiş sahtelik önleme çerçeveleri ve derin öğrenme tekniklerini öne çıkardı. Yine de (Zhang ve ark., 2025), mevcut deepfake konuşma tespit yöntemlerinin sağlamlık, açıklanabilirlik ve gerçek dünya uygulamaları konusundaki sınırlılıklarını vurguladı. Bu düşünceyle, araştırma odakları son zamanlarda daha iyi ses deepfake tespiti elde etmek için akustik, dilbilgisel ve duygu bilgisini birleştiren hibrit sistemlere yönelmiştir.
2.3 Konuşmada duygu: Deepfake tespitini güçlendirme
Chen ve ark. (2021), insan konuşmasının küçük ses tonu değişimi, şiddet, ritim ve zamanlama gibi duygu özelliklerinin gerçek ve sentetik konuşmayı ayırt etmek için önemli ipuçları olduğunu öne çıkardı. Güncel deepfake sentez modelleri prosodiyi iyi yakalayabilsin, ancak Tan ve Wu (2022)’nın belirttiği gibi doğal duygu dinamiklerini kaçırabiliyor. (Delgado ve ark., 2022), RAVDESS ve CREMA-D gibi duygu tanıma veri setlerinin ayırt edici duygu temsillerini öğrenmeyi kolaylaştırdığını gösterirken, (Li ve ark., 2024) farklı duygu koşulları boyunca konuşmacı temsilini iyileştirmek için kendi dikkatini kullanan bir duygu gömme çerçevesi önerdi.
Xing ve ark. (2024), major depresif bozukluk tespitinde çok modlu özellik birleştirmesiyle uyumlu çoklu grafik sinir ağı önerdi. Çalışmaları, karmaşık sınıflandırma görevlerinde tamamlayıcı temsilleri öğrenmede çok modlu özellik entegrasyonunun uygulamasını göstermektedir.
Moorthy ve Moon (2025), çok modlu özellik birleştirmesi yoluyla ses-görsel duygu tanıma için hibrit çoklu dikkat ağı önerdi ve duygu tanıma için tamamlayıcı ses ve görsel temsillerin birleştirilmesinin önemini vurguladı.
Ayrıca, (Conti ve ark., 2022), konuşma duygu tanıma yoluyla elde edilen yüksek düzeyli duygu özelliklerinin, sentetik duygu davranışındaki tutarsızlıkları yakalamak suretiyle deepfake konuşma tespitini etkili biçimde iyileştirdiğini göstermiştir. (Hosler ve Wang, 2021b), ince prosodik uyumsuzlukların sentetik seslerin tespitinde iyi göstergeler olduğunu bulmuştur. Bu bulgulara dayanarak, (Pepino ve ark., 2020) ve (Nguyen ve ark., 2025), deepfake konuşma tespit sistemlerinin sağlamlığını artırmak için akustik, dilbilgisel ve bağlamsal bilgiyi birleştiren hibrit yaklaşımları öne çıkarmıştır (Tablo 1).
Tablo 1
| S. No. | Yazar (yıl) | Yöntemler/teknikler | Temel bulgular | Açıklar/sınırlamalar |
|---|
| 1 | (Gupta ve ark., 2024) | Otomatik Konuşmacı Doğrulama (ASV) güvenlik analizi | ASV sistemlerinin modern ses klonlama saldırılarına karşı hassas yanlarını öne çıkarmıştır | Etkili bir deepfake tespit çerçevesi önermemiştir |
| 2 | (Yan ve Liu, 2024) | Duygu bilincili sahte konuşma tespit için EmoFake veri seti | Sentetik konuşma tespiti için duygu odaklı bir değerlendirme kriteri tanıtmıştır | Sınırlı veri seti boyutu ve çeşitli sahtecilik teknikleri üzerinde değerlendirme |
| 3 | (Liu ve ark., 2022) | ASVspoof 2021 değerlendirme kriteri | Sentetik konuşma tespiti için standartlaştırılmış veri setleri ve değerlendirme protokollerini kurmuştur | Öncelikli olarak yeni tespit modellerinden çok değerlendirme kriteri değerlendirmesine odaklanmıştır. |
| 4 | (Das, 2021) | CQT özellikleri ve hafif CNN ile veri çoğaltma stratejileri | Çeşitli sahtecilik saldırılarına karşı sağlamlığı ve tespit performansını artırmıştır | Performans, seçilen çoğaltma stratejilerinin ve değerlendirme senaryolarının etkinliğine bağlıdır |
| 5 | (Shin ve ark., 2023) | HM-Conformer mimarisi | Konvolüsyon ve temsilci (transformer) temsillerinin birleştirilmesiyle gelişmiş tespit performansı elde edildi | Hesaplama karmaşıklığı ve eğitim maliyeti arttı |
| 6 | (Conti ve Pompili, 2022) | Duygu farkındalıklı sahte konuşma tespiti | Duygusal tutarsızlıkların sahte konuşma tespitinde tamamlayıcı ipuçları sağladığını gösterdi | Tesperformansı, duygusal özelliklerin güvenilir biçimde çıkarılmasına bağlıdır. |
| 7 | (Javed ve ark., 2022) | ATCoP ve GTCC akustik özelliklerini kullanan birleşik anti-spoofing çerçevesi | Çoklu veri setlerinde tekrar, klonlama, klon-tekrar ve sahte konuşma tespitini iyileştirdi | Tesperformansı, daha çeşitli gerçek dünya ve görülmemiş spoofing koşullarında doğrulamaya ihtiyaç verir |
| 8 | (Zhang ve ark., 2025) | Ses sahte tespit yöntemlerinin kapsamlı derlemesi | Son veri setlerini, özellik çıkarma tekniklerini, derin öğrenme modellerini ve açıklanabilir tespit yaklaşımlarını inceledi | Sağlamlık, açıklanabilirlik, gizlilik, adalet ve gerçek dünya uygulaması alanlarında zorlukları ortaya koydu |
| 9 | (Chen ve ark., 2021) | Kanal dayanıklı sentetik konuşma tespiti (ASVspoof 2021) | Kanal uyumsuzluğu koşullarında sağlamlığı artırdı | Görülmemiş sentez yöntemlerine genelleme zorluğunu koruyor |
| 10 | (Pepino ve ark., 2020) | BERT gömme (embedding) kullanarak akustik ve metin tabanlı özelliklerin birleştirilmesi | Akustik ve metinsel temsillerin birleştirilmesinin konuşma duygu tanıma performansını artırdığını gösterdi | Duygu tanıma üzerine odaklandı, sahte konuşma tespiti üzerine değil |
| 11 | (Tak et al., 2021) | Yalancı ve deepfake konuşma tespiti için ASVspoof 2021 temel ölçütü. | Deepfake tespiti için standartlaştırılmış değerlendirme protokollerini oluşturdu. | Görülen veri setleri ve saldırılara karşı sınırlı genelleştirme. |
| 12 | (Tak et al., 2021); (Firc et al., 2025) | Ham dalga formlarını kullanan RawNet2 uçtan uca anti-spoofing. | ASVspoof 2019’da güçlü performans gösterdi. | Yükhesaplama maliyeti ve görülen saldırılara karşı sınırlı dayanıklılık. |
Ses deepfake tespiti ve anti-spoofing teknikleri üzerine güncel çalışmaların özeti.
2.4 Araştırma açığı
Deepfake konuşma tespitindeki ilerlemeye rağmen, mevcut yaklaşımların çoğu temel olarak akustik, spektral veya öğrenilmiş konuşma temsillerine dayanırken, duygu ile ilgili bilgilerin katkısı yeterince net biçimde ortaya konmamıştır. Konuşma duyguları prosodi, perdesi, ritim, şiddet ve zamansal özellikler aracılığıyla yansır ve bunlar gerçek ile sentetik konuşmayı ayırt etmek için tamamlayıcı bilgiler içerebilir. Ancak duygusal özelliklerin yalnızca dahil edilmesi, onların deepfake tespit performansını iyileştirmediğini gösterir. Bu nedenle, aktarılmış bir duygusal temsil, geleneksel akustik temsillerin ötesinde ek ayırt edici bilgi sağlayıp sağlamadığını belirlemek için sistematik bir değerlendirme gerekmektedir. Buna ek olarak, mevcut değerlendirmelerin çoğu mimari bileşenlerin katkısını yeterince izole etmemiş veya farklı veri bölümleri üzerinde performans kararlılığını değerlendirmemiştir. Bu açıkları kapatmak için bu çalışma, duygulara duyarlı bir Enhanced FusionNet geliştirmekte ve bunu bağımsız hold-out testleri, beş katlı çapraz doğrulama, bileşen düzeyinde ayrıştırma, istatistiksel belirsizlik analizi ve yalnızca akustik ile akustik плюс duygusal yapılandırmalar arasındaki kontrollü karşılaştırma yoluyla değerlendirmektedir.
2.5 Özgün katkılar
Bu çalışmanın temel katkıları aşağıdaki gibidir:
-
Geliştirilmiş FusionNet mimarısı: MultiScaleCNN, BiLSTM, Çok Başlı Çapraz Dikkat, Artıklı Özellik Birleştirmesi, Uyarlamalı Kapalı Birleştirmesi ve dikkat tabanlı havuzlama’yı birleştiren bir sahte konuşma tespit mimarısı.
-
Sıralı duygu bilinçli temsil öğrenmesi: Duygu temsilini belirlemek için önce konuşmacıdan bağımsız bir duygu kodlayıcısı kullanılarak RAVDESS veri kümesi üzerinde öğrenilir ve ardından FoR tabanlı sahte konuşma tespit çerçevesine aktarılır.
-
Duygu bilgisinin kontrollü değerlendirmesi: Aktarılan duygu temsilinin katkısını belirlemek amacıyla doğrudan yalnızca FoR ile FoR + Duygu deneyi karşılaştırılır; ek guvu bilgisinin tespit performansını iyileştirdiği varsayılmaz.
-
Kapsamlı mimari analizi: MultiScaleCNN, BiLSTM, Çapraz Dikkat, Artıklı Birleştirmesi, Uyarlamalı Kapama ve Dikkat Havuzlama’nın katkısını incelemek için bileşen düzeyinde yoklama (ablation) deneyleri gerçekleştirilir.
-
Sağlam değerlendirme protokolü: Çerçeve, değerlendirilen FoR bölümleri boyunca tutarlılığı değerlendirmek için bağımsız bir ayrı tutma test kümesi, beş katmanlı çapraz doğrulama ve istatistiksel belirsizlik analizi kullanılarak değerlendirilir.
-
Güvenlik odaklı performans değerlendirmesi: Gelenekli sınıflandırma metriklerine ek olarak, sahte konuşma tespit performansının daha detaylı değerlendirilmesini sağlamak için duyarlılık, özgüllük, FAR, FRR, EER ve ROC-AUC raporlanır.
3 Metodoloji
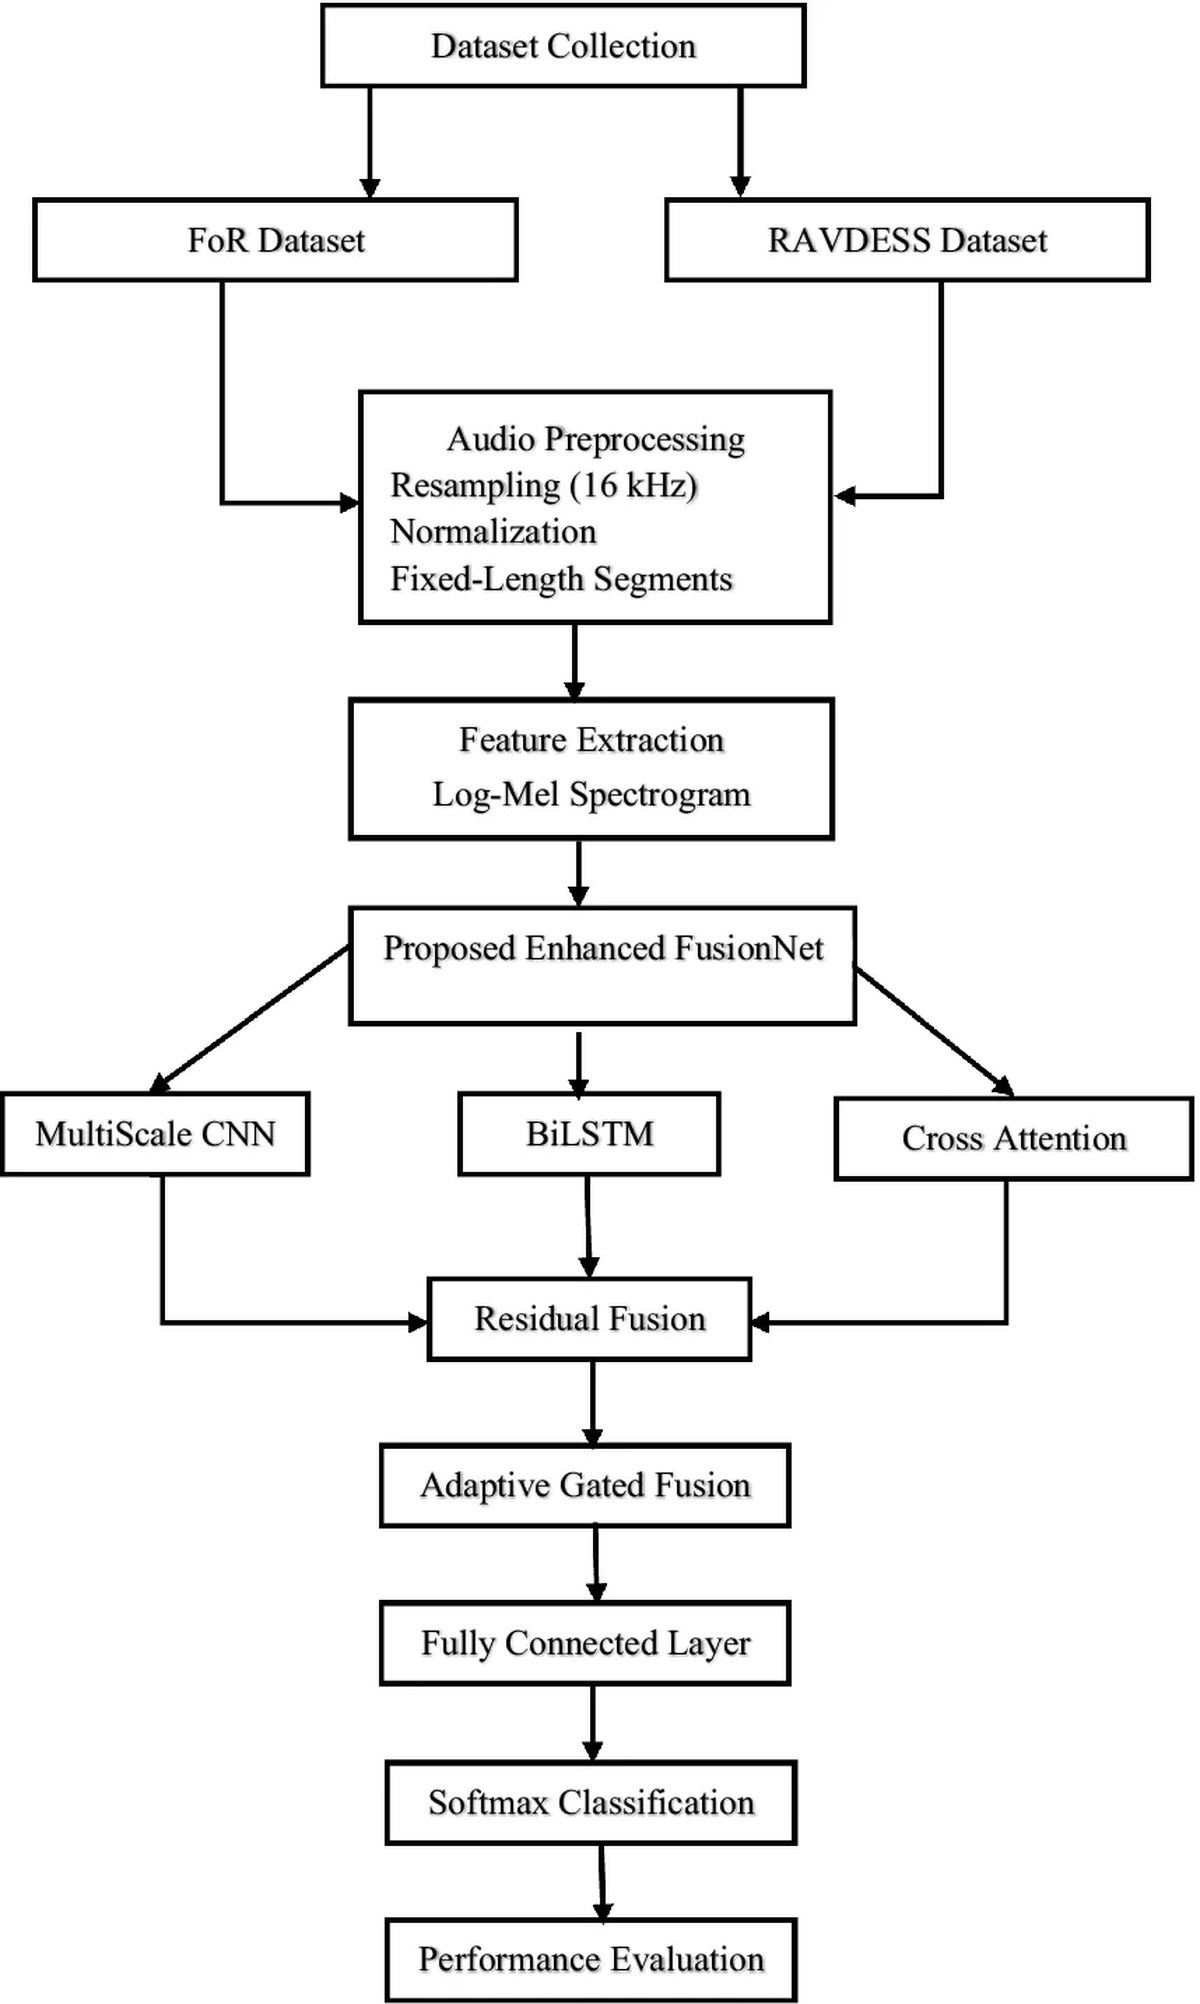
Bu çalışmada, sahte ses tespitinde duygu bilincine sahip bir derin öğrenme çerçevesi olan Enhanced FusionNet önerilmektedir. Önerilen ses işleme metodolojisi, ses ön işleme, derin özellik çıkarma, özellik birleştirme ve gözetimli sınıflandırma’yı bir araya getirmektedir. FoR ve RAVDESS ses örnekleri başlangıçta standartlaşmış akustik temsiller üretmek için ön işlenmektedir. FoR tabanlı özellikler ardından, ikili sınıflandırma için ayırt edici temsiller öğrenmek amacıyla çok ölçekli özellik çıkarma, zamanlı modelleme, dikkat temelli özellik etkileşimi ve uyarlamalı birleştirme’yi içeren önerilen Enhanced FusionNet kullanılarak işlenmektedir. Duygu temsili RAVDESS’ten ayrı ayrı öğrenilmekte ve ardından kontrollolu duygu bilincili değerlendirmede aktarılmaktadır. Son olarak, önerilen çerçevenin etkinliği, bağımsız tutma testi, beş katmanlı çapraz doğrulama, ortadan kaldırma analizi, istatistiksel belirsizlik analizi ve kontrollolu duygu-temsil değerlendirmesi kullanılarak değerlendirilmektedir (Şekil 2).
Şekil 2
3.1 Önerilen gelişmiş FusionNet’in genel çerçevesi
Önerilen Enhanced FusionNet, ikili sahte ses tespitinde çok ölçekli akustik özellik çıkarma, zamanlı modelleme, dikkat temelli özellik etkileşimi, artımsal birleştirme ve uyarlamalı özellik kapama’yı bir araya getirmektedir. Çerçeve, çıkarılmış ses temsillerini MultiScaleCNN ve BiLSTM üzerinden işlemekte, ardından Cross-Attention, Residual Feature Fusion, Adaptive Gated Fusion ve Attention Pooling aşamalarından geçirmekte ve son olarak gerçek veya sentetik ses olarak ikili sınıflandırma yapmaktadır. RAVDESS’ten ayrı ayrı öğrenilen duygu temsili ardından kontrollolu duygu bilincili değerlendirmede aktarılmaktadır.
3.2 Veri seti açıklaması
Bu çalışmada iki açık veri seti kullanıldı: Sahte konuşma tespiti için FoR (Fake or Real) ve duygu temsili öğrenmesi için RAVDESS (Ryerson Ses-Görsel Duygusal Konuşma ve Şarkı Veri Tabanı). Kalite değerlendirmesi ve tekrarların kaldırılmasından sonra nihai FoR veri seti 8.358 kayit içeriyordu; bunlar 4.167 gerçek ve 4.191 sahte örnekten oluşuyordu. Temizlenmiş RAVDESS alt kümesi ise sekiz duygu kategorisinde 24 aktörden 1.439 kayit içeriyordu. Her iki veri seti de 16 kHz örnekleme hızında işlendi.
Bağımsız ayırılmış değerlendirme için FoR; 5.963 eğitim örneği (2.970 gerçek ve 2.993 sahte), 1.196 doğrulama örneği (598 gerçek ve 598 sahte) ve 1.199 bağımsız test örneği (599 gerçek ve 600 sahte) olacak şekilde katmanlı olarak bölündü. Doğrulama seti model geliştirme sırasında kullanıldı, bağımsız test seti ise nihai değerlendirme için ayrık tutuldu. FoR’da tutarlı konuşmacı kimlikleri bulunmadığından katılımcıdan bağımsız bölütleme mümkün olmadı. RAVDESS için ise konuşmacı düzeyinde bölütleme 960 eğitim, 240 doğrulama ve 239 görülmemiş konuşmacılı test kayidi üreterek duygu kodlayıcının katılımcıdan bağımsız değerlendirmesini olanaklı kıldı (Tablo 2).
Tablo 2
| Veri seti | Kullanım amacı | Toplam örnek | Sınıflar | Örnekleme hızı | Bölütleme |
|---|---|---|---|---|---|
| FoR | Sahte konuşma tespiti | 8.358 | Gerçek, sahte | 16 kHz | Eğitim: 5.963; doğrulama: 1.196; test: 1.199 |
| RAVDESS | Duygu temsili öğrenmesi | 1.439 | 8 duygu | 16 kHz | Eğitim: 960; doğrulama: 240; test: 239 |
Bu çalışmada kullanılan veri setlerinin özeti.
3.3 Akustik ve derin konuşma özelliği çıkarma
Ön işlenmiş konuşma sinyali, Kısa Süreli Fourier Dönüşümü (STFT) kullanılarak zaman-sıklık temsiline dönüştürüldü (Denklem 1): burada girdi sinyali, analiz penceresini, çerçeve dizinini, atlama uzunluğunu, sıklık kutusunu ve FFT boyutunu temsil eder.
İlgili güç spektrumu şu şekilde hesaplanır (Denklem 2)
512 noktalı bir FFT, 400 örneklemlilik Hann penceresi, 160 örneklemlilik atlama uzunluğu ve 20 Hz–8 kHz aralığını kapsayan 64 Mel filtre bankası kullanıldı.
Mel-filtre-bankası enerjileri (Denklem 3) ile ifade edilir ve Log-Mel temsili (Denklem 4) kullanılarak elde edilir; burada , -nci Mel filtresini ve küçük bir sayısal kararlılık sabitini gösterir.
Ses bilgilenim özniteliklerinin yanı sıra, önceden eğitilmiş Wav2Vec 2.0 BASE temsilleri çıkarıldı. , zaman konumundaki temsili göstermek kaydıyla, zaman ortalamalı havuzlama işlemi (Denklem 5) sonucunu üretir.
Elde edilen 768 boyutlu derin temsili, MFCC/delta öznitelikleri, havuzlanmış Log-Mel öznitelikleri, spektral kontrast, chroma, sıfır geçiş oranı ve RMS-enerji öznitelikleriyle birleştirildi. Elde edilen FoR temsili (Denklem 6) ile ifade edilir; (Denklem 7) ile.
1.016 boyutlu vektör ardından FusionNet girdisi için bir temsile dönüştürüldü. Böylece 127 × 8, birleşik öznitelik vektörünün yeniden yapılandırılmasıdır ve native Log-Mel spektrogramı boyutu değildir.
3.4 Duygu temsili öğrenme ve aktarım
Duygu bilgisi, doğrudan ortak duygu/deepfake sınıflandırması yerine ayrı bir temsili öğrenme aşaması aracılığıyla sisteme dahil edildi. Özel bir duygu kodlayıcısı, konuşmacı düzeyinde eğitim, doğrulama ve konuşmacı görülmeyen test bölümleriyle RAVDESS veri kümesi kullanarak eğitildi.
768 boyutlu Wav2Vec 2.0 temsili, katman normalleştirmeli ve GELU aktivasyonlu tam bağlantılı katmanlar kullanılarak (Denklem 8) dönüştürüldü; ardından (Denklem 9) ile sonuçlanan duygu temsili 128 boyutludur.
Duygu kodlayıcısı, FoR çerçevesine aktarılmadan önce ayrı ayrı görülmeyen RAVDESS konuşmacıları üzerinde değerlendirildi. Aktarılan 128 boyutlu temsil yalnızca kontrollü duygu deneyinde FoR temsiliyle birleştirildi. Sonuç olarak çalışma, duygu bilgisinin deepfake tespitini kaçınılmaz olarak iyileştireceğini varsaymaz; bunun yerine katkısı ampirik olarak değerlendirilir.
Kontrollü deney için, yalnızca FoR yapılandırması 1.016 boyut içerirken, aktarılan 128 boyutlu duygu temsili eklendikten sonra FoR + Duygu yapılandırması 1.144 boyut içermektedir. Duygu temsili RAVDESS’ten ayrı olarak öğrenilip ardından FoR tabanlı tespit deneyine aktarıldığından, duygu- farkındalıklı (emotion-aware) terimi kullanılmaktadır; birincil FusionNet, eşzamanlı iki giriş modülü olarak birlikte eğitilmemektedir.
3.5 Geliştirilmiş FusionNet mimarisi
Şekil 3’te önerilen mimari; MultiScaleCNN dalı, BiLSTM zamanlı dalı, Çok Başlı Çapraz Dikkat, Kalıntılı Özellik Birleştirmesi, Uyarlamalı Kapalı Birleştirmesi, dikkat havuzlaması ve tamamen bağlı ikili sınıflandırıcıdan oluşmaktadır.
Şekil 3
MultiScaleCNN, farklı alım alanı boyutlarına sahip konvolüsyonel çekirdekler kullanarak yerel akustik örüntüleri çıkarır (Denklem 10):
Çıktılar birleştirilir (Denklem 11):
Birleştirilen temsil, normalize edilir, aktive edilir ve ortak özellik alanına projekte edilir (Denklem 12):
Ardından bir kalıntılı dönüşüm uygulanır (Denklem 13):
Paralel olarak, BiLSTM dalı zamanlı bağımlılıkları modeller. İleri ve geri gizli durumlar şu şekilde birleştirilir (Denklem 14)
Convolüsyonel ve zamanlı temsiller ardından çok başlı dikkat aracılığıyla birleştirilir. Her dikkat başı için (Denklem 15)
Çok başlı çıktılar birleştirilir ve projekte edilir (Denklem 16):
Kalıntılı normalize ve ileri besleme işleminden sonra uygulanır (Denklem 17) ve (Denklem 18)
Dikkat temsili, konvolüsyonel temsille kalıntılı özellik birleştirmesiyle birleştirilir (Denklem 19):; ardından nonlinear projeksiyon ve kalıntılı normalize (Denklem 20):
Uyarlamalı Kapalı Birleştirmesi öğrenilebilir bir kapama vektörü üretir (Denklem 21):; ve kapalı temsil şu şekilde elde edilir (Denklem 22)
Son olarak, dikkat havuzlaması bilgilendirici zamanlı konumları özetler (Denklem 23, 24) ve (Denklem 25)
Pooled temsil, nihai ikili tahmine ulaşmak için tamamen bağlı katmanlardan geçirilir (Denklem 26):
Tahmin edilen sınıf (Denklem 27)
3.6 Model eğitimi ve yeniden üretilebilirlik
Önerilen model, eğitilenmiş ikili sınıflandırma ile birlikte çapraz entropi kayıpları ve etiket yumuşatma kullanılarak eğitildi. Kayıp fonksiyonu (Denklem 28) olarak tanımlanır burada tahmin edilen olasılığı ve yumuşatılmış hedefi temsil eder.
Yumuşatılmış hedef (Denklem 29) olarak ifade edilir burada ve .
Optimizasyon için optimizer olarak AdamW kullanıldı ve başlangıç öğrenme hızı 3 × 10⁻⁴, ağırlık çürümesi 5 × 10⁻⁴ olarak ayarlandı. Optimizasyon sırasında kosinüs soğutma öğrenme hızı planı kullanıldı ve parti boyutu 64 olarak belirlendi.
Değerlendirme için beş katmanlı katmanlı çapraz doğrulama stratejisi tanımlandı ve her katmanda eğitim kısmının %10’u doğrulama için ayrıldı. Katmanlar boyunca aynı eğitim, doğrulama ve değerlendirme yapılandırması korundu.
Uygulama PyTorch, NumPy ve scikit-learn kullanılarak gerçekleştirildi. Veri seti bölümlendirmesi, ön işleme ayarları, özellik çıkarma parametreleri, model mimarisi, optimizasyon parametreleri ve değerlendirme prosedürleri deney değerlendirmesinden önce belirlendi. Deneylerde boyunca sabit rastgele tohum değeri 42 kullanıldı. CUDA mevcut olduğunda, yeniden üretilebilirliği artırmak için deterministik cuDNN ayarları etkinleştirildi.
3.7 Değerlendirme metrikleri ve güvenlik odaklı önlemler
Model performansı Doğruluk, Kesinlik, Geri Çağırma/Hassaslık, Belirtilik, F1-skoru, ROC-AUC, FAR, FRR ve EER kullanılarak değerlendirildi.
Doğruluk (Denklem 30) olarak tanımlanır
Kesinlik (Denklem 31) ile verilir
Geri Çağırma veya hassaslık (Denklem 32) ile hesaplanır
Belirtilik (Denklem 33) olarak tanımlanır
F1-skoru (Denklem 34) ile hesaplanır
Güncilik odaklı değerlendirmede, Yanlış Kabul Oranı ve Yanlış Red Oranı sırasıyla (Denklem 35) ve (Denklem 36) olarak hesaplandı
Eşit Hata Oranı, FAR ve FRR’nin yaklaşık olarak eşit olduğu işletim noktasında belirlendi (Denklem 37):
ROC-AUC, farklı sınıflandırma eşikleri arasındaki ayrımı değerlendirmek için kullanıldı. Bu güvenlik odaklı ölçümler, tespit önlemleri olarak raporlanır ve modelin kapsamlı bir ses biyometrik sahte konuşma tespit sistemi oluşturduğunu gösteren kanıt olarak yorumlanmaz. Önerilen yöntem, ikili gerçek/sahte konuşma sınıflandırması yapar ve kapsamlı bir konuşmacı doğrulama veya ses biyometrik kimlik doğrulama hattı olarak yorumlanmamalıdır.
3.8 Çapraz doğrulama ve istatistiksel belirsizlik
Performans kararlılığının farklı FoR bölümleri üzerinden değerlendirilmesi için beş katmanlı stratif çapraz doğrulama gerçekleştirildi. Her katmanda bir dış değerlendirme bölümü bulunurken, kalan veriler model geliştirmesi için iç doğrulama alt kümesiyle birlikte kullanıldı. Tüm katmanlar boyunca aynı mimari ve sabit eğitim protokolü korundu.
Ortalama performans, (Denklem 38) formülüyle hesaplandı; burada ve , katmandan elde edilen metriği ifade eder.
Örnek standart sapma, (Denklem 39) formülüyle hesaplandı.
Ayrıca, Doğruluk, Kesinlik, Geri Çağırma, F1-skoru ve ROC-AUC için %95 güven aralıklarının tahmin edilmesi amacıyla tam katman dışı tahminlerin 10.000 bootstrap yeniden örneklemesi kullanıldı.
Aynı son beş katmanlı protokol altında eşleştirilmiş temel sonuçlar her referans model için mevcut olmadığından, istatistiksel analiz, istatistiksel açıdan anlamlılığın kanıtı olarak değil, performans kararlılığının ve belirsizliğinin bir değerlendirmesi olarak sunulur. Bu yaklaşım, eşanlı önemlilik testlerine dayanan desteklenmeyen iddialardan kaçınır.
3.9 Ayrıştırma ve karşılaştırmalı değerlendirme
Bileşen düzeyinde bir ablasyon çalışması, Enhanced FusionNet’in mimari bileşenlerinin katkılarını incelemek amacıyla tasarlandı. Değerlendirilen yapılandırmalar, tam modeli ve MultiScaleCNN, BiLSTM, Cross-Attention, Residual Feature Fusion, Adaptive Gated Fusion ve Attention Pooling bileşenlerinin tek tek çıkarılmasıyla elde edilen varyantları içeriyordu. Deneylerin her birinde uygulandığı gibi korunan yapılandırma ile sınıflandırma performansı Accuracy, Precision, Recall, Specificity, F1-score ve ROC-AUC kullanılarak değerlendirildi. Bu analizin amacı, değerlendirilen bileşen-çıkarma yapılandırmalarıyla ilişkili performans değişikliklerini incelemekti.
Aktarılan duygu temsili, aynı değerlendirme koşulları altında yalnızca FoR ve FoR + Emotion yapılandırmaları karşılaştırılarak ayrıca incelendi. Bu karşılaştırma, deuterme konuşma sınıflandırmasına aktarılan duygu temsili dahil etmenin etkisini değerlendirmeyi amaçlıyordu. Duygu tabanlı deney, aktarılan duygu temsili birincil Enhanced FusionNet mimarisinin birlikte eğitilen bir bileşeni olarak değil, ek bir yapılandırma olarak değerlendirildiği için bileşen düzeyinde ablasyon analizinden ayrı tutuldu.
Bulgular, uygulanan deney yapılandırmaları ve değerlendirme prosedürleri kapsamında yorumlandı. Analiz, nedensel etkiler kurmayı veya değerlendirilen veri setinin ötesinde genelleme göstermeyi amaçlamıyordu.
3.10 Deneysel bütünlük ve değerlendirme protokolünün sınırlamaları
Bağımsız FoR test bölütleme’si, model geliştirme ve son model seçiminden izole edildi. Beş katmanlı çapraz doğrulama prosedürü, her örneği dış değerlendirme katmanı aracılığıyla ayrıca değerlendirdi; bootstrap analizi ise ortaya çıkan katman dışı metriklerin etrafında belirsizlik tahminleri sağladı. RAVDESS duygu temsili, FoR çerçevesine aktarılmadan önce konuşmacı düzeyinde ayrıştırma kullanılarak bağımsız olarak öğrenildi.
Aynı zamanda mevcut FoR meta verileri üzerinde bir çapraz bölünme içeriği sızıntısı denetimi gerçekleştirilmiş ve uygulanan denetim prosedürü altında çapraz bölümler arasında içerik örtüşmesi tespit edilmemiştir. Yine de, FoR içinde güvenilir konuşmacı kimliklerinin tutarlı şekilde mevcut olmaması nedeniyle değerlendirme, katı konuşmacıdan bağımsız genelleme kuramaz. Benzer şekilde, daha önce görülmemiş sentez yöntemlerini içeren dış bir veri seti üzerinde değerlendirme, mevcut deneysel tasarımın bir parçası değildi. Bu sınırlamalar, dolayısıyla bildirilen performans yorumlanırken açıkça göz önüne alınmaktadır.
Bu nedenle önerilen çerçeve, tamamen doğrulanmış bir gerçek dünyada sahte konuşma tespit sistemi yerine, temel ölçüt koşulları altında bir sahte konuşma tespit sistemi olarak değerlendirilmektedir. Çapraz veri seti doğrulaması, görülmemiş üretim testi, RawNet2/Conformer tabanlı sistemler gibi güncel anti-spoofing taban değerleri ve gerçek dünyada uygulama ölçümleri, sonraki değerlendirme için önemli yönler olarak kalmaktadır.
4 Sonuçlar ve analiz
Bu bölümde, sahte konuşma tespiti için önerilen Enhanced FusionNet’in deneysel doğrulaması sunulmaktadır. Model; sınıflandırma performansı, çapraz doğrulama, istatistiksel analiz, ortadan kaldırma çalışması (ablation), özellik temsili, hata analizi ve karmaşıklık analizi gibi çeşitli nicel ve nitel analizlerle değerlendirilerek etkinliği, dayanıklılığı ve güvenilirliği öne çıkarılmaktadır.
4.1 Önerilen gelişmiş FusionNet’in performans değerlendirmesi
Önerilen Enhanced FusionNet’in performansı, yaygın şekilde kullanılan beş sınıflandırma metriği kullanılarak değerlendirilmiştir: doğruluk (accuracy), kesinlik (precision), geri çağırma (recall), F1 skoru ve ROC-AUC. Bu metrikler, modelin doğru pozitif tahminler ve kaçırılan tespitler dikkate alınarak gerçek ve sahte konuşma arasındaki ayrımı yapma yeteneğine kapsamlı bir değerlendirme sunmaktadır. Önerilen modelin genel performansı Tablo 3’te sunulmaktadır.
Tablo 3
| Ölçü | Değer |
|---|---|
| Doğruluk (%) | 98,67 |
| İsabet (%) | 98,18 |
| Hatırlama (%) | 99,17 |
| F1-puanı (%) | 98,67 |
| ROC-AUC (%) | 99,88 |
Önerilen gelişmiş FusionNet’in genel performans gösterimi.
Önerilen gelişmiş FusionNet, bağımsız FoR ayırma test kümesinde 98,67% doğruluk, 98,18% isabet, 99,17% hatırlama, 98,67% F1-puanı ve 99,88% ROC-AUC değerlerine ulaştı. Yüksek hatırlama değeri, modelin sahte konuşma örneklerinin büyük bir oranını doğru biçimde tespit ettiğini gösterirken, ROC-AUC değeri sınıflandırma eşikleri boyunca gerçek ve sentetik konuşma arasında güçlü ayrım sağladığını ortaya koyuyor. F1-puanı, isabet ve hatırlama dengeli bir tespit performansını daha da gösteriyor.
D_tablo 4’te sunulan sınıflandırma sonuçları, önerilen gelişmiş FusionNet’in bağımsız 1.199 örneklik ayırma test kümesinde gerçek ve sahte konuşma örnekleri arasında etkili ayrım sağladığını gösteriyor. Model, Real sınıfı için 0,98 isabet, 0,98 hatırlama ve 0,99 F1-puanı elde ederken, Fake sınıfı 0,98 isabet, 0,99 hatırlama ve 0,99 F1-puanı elde etti. 0,99 olan makro ortalamalı ve ağırlıklı ortalamalı F1-puanları, iki sınıf arasında dengeli bir sınıflandırma performansını daha da gösteriyor.
D_tablo 4
| Sınıf | İsabet | Hatırlama | F1-puanı | Destek |
|---|---|---|---|---|
| Real | 0,98 | 0,98 | 0,99 | 599 |
| Fake | 0,98 | 0,99 | 0,99 | 600 |
| Doğruluk | — | — | 0,99 | 1.199 |
| Makort ortalaması | 0,98 | 0,99 | 0,99 | 1.199 |
| Ağırlıklı ortalaması | 0,98 | 0,99 | 0,99 | 1.199 |
Önerilen gelişmiş FusionNet’in sınıflandırma raporu.
Şekil 4’teki karışıklık matrisi, önerilen Enhanced FusionNet’in 599 gerçek konuşma örneğinin 588’ini Doğru olarak sınıflandırdığını, 11 gerçek örneğin ise Yanlış olarak hatalı sınıflandırıldığını göstermektedir. Yanlış sınıf için 600 örneğin 595’i Doğru şekilde Yanlış olarak tanımlandı ve yalnızca 5 örneğin Doğru olarak hatalı sınıflandırıldığı görülmektedir. Böylece 1.199 test örneğinin 1.183’ünde doğru tahmin verilmiş olup, bu durum %98,67’lik bir doğruluk oranına karşılık gelmektedir; bu sonuç, Tablo 3 ve Tablo 4’te bildirilen genel sınıflandırma sonuçlarıyla tutarlıdır.
Şekil 4
Şekil 5’teki ROC eğrisi, önerilen Enhanced FusionNet’in gerçek ve yanlış konuşma örneğini ayırt etmedeki güçlü ayrıştırıcı yeteneğini göstermektedir. Eğri, üst-sol köşeye yakın kalmakta ve farklı karar eşiklerinde yüksek gerçek-pozitif oranıyla nispeten düşük negatif-pozitif oranı olduğunu ortaya koymaktadır. Model, 0,9988 değerinde bir ROC-AUC elde etmiş olup, bu durum iki konuşma sınıfı arasında güçlü bir ayrışma olduğunu göstermektedir. Karşılaştırma yapmak gerekirse, kesikli çizgili köşegen çizgi, 0,5 AUC’ye karşılık gelen rastlantısal bir sınıflandırıcının performansını temsil etmektedir. ROC eğrisinin rastlantısal sınıflandar referansından ayrışması, farklı sınıflandırma eşiklerinde iki konuşma sınıfı arasında etkili bir ayrıştırma sağlandığını göstermektedir.
Şekil 5
4.2 Çapraz doğrulama performans analizi
Önerilen Enhanced FusionNet’in farklı veri bölümleri arasındaki tutarlılığını değerlendirmek için FoR veri seti üzerinde 5 katmanlı katmanlı çapraz doğrulama gerçekleştirilmiştir. Her katmanda, dış test kümesi model eğitimi sırasında tamamen görülmemiş kalmış; eğitim kısmı ise iç eğitim kümesi ve iç doğrulama kümesi olarak ayrılmıştır. Beş katmanın tamamında aynı deney konfigürasyonu korunmuştur. Katman bazında elde edilen sonuçlar Tablo 5’te sunulmaktadır.
Tablo 5
| Fold | Test örnekleri | Doğruluk (%) | İsabetlilik (%) | Hatırlama (%) | F1-skoru (%) | ROC-AUC (%) |
|---|---|---|---|---|---|---|
| 1 | 1,672 | 99.28 | 98.93 | 99.64 | 99.29 | 99.96 |
| 2 | 1,672 | 99.28 | 99.17 | 99.40 | 99.28 | 99.96 |
| 3 | 1,672 | 98.56 | 97.77 | 99.40 | 98.58 | 99.87 |
| 4 | 1,671 | 98.86 | 98.81 | 98.93 | 98.87 | 99.91 |
| 5 | 1,671 | 99.40 | 99.17 | 99.64 | 99.40 | 99.98 |
Önerilen geliştirilmiş FusionNet’in beş katmanlı çapraz doğrulama performansı.
Önerilen geliştirilmiş FusionNet, beş dış test katmanının tamamında tutarlı biçimde yüksek performans gösterdi. Sınıflandırma doğruluğu %98,56 ile %99,40 arasında, isabetlilik ise %97,77 ile %99,17 arasında değişti. Hatırlama tüm katmanlarda özellikle yüksek kaldı ve %98,93 ile %99,64 arasında değişti; F1-skoru %98,58 ile %99,40 arasında değişti. ROC-AUC değerleri her katmanda %99,87’nin üzerinde kaldı ve bu da farklı bölütmeler gerçek sahte konuşma örnekleri arasında tutarlı bir ayrım yapıldığını gösteriyor.
Beş katmanlı sonuçların istatistiksel özeti Tablo 6’da sunulmuştur. Beş katman boyunca önerilen geliştirilmiş FusionNet ortalamada %99,08 ± 0,35 doğruluk, %98,77 ± 0,58 isabetlilik, %99,40 ± 0,29 hatırlama, %99,09 ± 0,35 F1-skoru ve %99,94 ± 0,05 ROC-AUC elde etti. Göreceli olarak küçük standart sapmalar, gözlemlenen performansın beş dış test katmanında tutarlı kaldığını gösteriyor.
Tablo 6
| Ölçü | Ortalık ± SD (%) | 95% güven aralığı (%) |
|---|---|---|
| Doğruluk | 99,08 ± 0,35 | 98,64–99,52 |
| İsabetlilik | 98,77 ± 0,58 | 98,05–99,49 |
| Gerçek pozitif oranı | 99,40 ± 0,29 | 99,04–99,77 |
| F1 skoru | 99,09 ± 0,35 | 98,65–99,52 |
| ROC-AUC | 99,94 ± 0,05 | 99,88–100,00 |
Beş katmanlı çapraz doğrulamanın istatistiksel özeti.
Genel olarak beş katmanlı sonuçlar, önerilen Enhanced FusionNet’in değerlendirilen veri bölümleri boyunca tutarlı bir performans sergilediğini; doğruluk, isabetlilik, gerçek pozitif oranı, F1 skoru ve ROC-AUC’de sınırlı değişkenlik gösterdiğini göstermektedir. Sonuçlar, modelin uygulanan çapraz doğrulama protokolü altındaki kararlılığını desteklemektedir. Ancak FoR veri seti, konuşmacıdan bağımsız bir ayrım oluşturmak için doğrulanmış konuşmacı kimlikleri sağlamadığından, bu sonuçlar konuşmacıdan bağımsız genelleme kanıtı yerine çapraz bölümlü doğrulama olarak yorum edilmelidir.
4.3 İstatistiksel doğrulama ve performans analizi
Önerilen Enhanced FusionNet’in kararlılığı, Tablo 7’deki beş dış katmanın ortalaması ve örnek standart sapması kullanılarak değerlendirildi. Model 99,08% ± 0,35% ortalık doğruluk, 98,77% ± 0,58% isabetlilik, 99,40% ± 0,29% gerçek pozitif oranı, 99,09% ± 0,35% F1 skoru ve 99,94% ± 0,05% ROC-AUC elde etti. Göreceli olarak küçük standart sapmalar, değerlendirilen katmanlar boyunca sınırlı bir değişkenliği işaret etmektedir. Belirsizlik, tüm katman dışı tahminlerin 10.000 bootstrap yeniden örnekleme ile ayrıca değerlendirildi. Elde edilen 95% bootstrap güven aralıkları doğruluk için 98,863–99,282%, isabetlilik için 98,417–99,091%, gerçek pozitif oranı için 99,157–99,623%, F1 skoru için 98,872–99,285% ve ROC-AUC için 99,893–99,965% oldu.
Tablo 7
| Ölçü | Ortalık ± SD (%) | 95% Bootstrap Güven Arlığı (%) |
|---|---|---|
| Doğruluk | 99,08 ± 0,35 | 98,863–99,282 |
| İsabetlilik | 98,77 ± 0,58 | 98,417–99,091 |
| Sezilirlik/geri çağırma | 99,40 ± 0,29 | 99,157–99,623 |
| F1-skoru | 99,09 ± 0,35 | 98,872–99,285 |
| ROC-AUC | 99,94 ± 0,05 | 99,893–99,965 |
Önerilen geliştirilmiş FusionNet’in istatistiksel doğrulaması.
Aynı değerlendirme protokolü altında eşlenmiş katman düzeyinde taban sonuçları mevcut olmadığından, taban modelleri üstünlüğü iddia etmek için eşleştirilmiş öneme sahiplik testi kullanılmadı. İstatistiksel analiz dolayısıyla performans kararlılığını ve belirsizliğini nicelendirmektedir, istatiksel üstünlüğü değil.
4.4 Değerlendirilen mimarinin ortadan kaldırma analizi
Birey mimari bileşenlerin etkisini incelemek için, tam model ile tek tek bir bileşeninin çıkarıldığı varyantlar karşılaştırilarak bir ortadan kaldırma (ablation) değerlendirmesi yapıldı. Değerlendirilen ölçüler Doğruluk, İsabetlilik, Geri Çağırma, Belirlik, F1-skoru ve ROC-AUC’ydi. Raporlanan sonuçlar uygulanan ortadan kaldırma yapılandırmalarına ve bunların atanan değerlendirme prosedürüne karşılık gelir. Ancak ortadan kaldırma uygulaması mimari olarak önerilen Enhanced FusionNet’ten farklı olduğundan, bu sonuçlar önerilen tam mimarinin doğrudan, kontrollü bir ortadan kaldırması olarak değil, uygulanan bileşen varyantlarının bir değerlendirmesi olarak yorumlanmalıdır. Tablo 8’de tam model için raporlanan %99,16’lık doğruluk ayrı bir değerlendirme sonucudur ve Tablo 7’de raporlanan 99,08% ± 0,35% beş katmanlı çapraz doğrulama ortalaması olarak yorumlanmalıdır. Aktarılan duygu temsili, birincil FusionNet mimarisinin eş zamanlı eğitilen bir dalı olarak değil, sırayla öğrenildiği için ayrı ayrı değerlendirildi. Buna göre bulgular, uygulanan değerlendirmenin kapsamı içinde yorumlanır ve değerlendirilen veri setinin ötesinde nedensel etkiler veya genelleme ortaya koymaz.
Tablo 8
| Model | Doğruluk (%) | Ölçüllük (%) | Hatır (%) | Spesifiklik (%) | F1-skoru (%) | ROC-AUC (%) |
|---|---|---|---|---|---|---|
| Tam Model | 99.16 | 99.16 | 99.16 | 99.16 | 99.16 | 99.95 |
| MultiScaleCNN Olmadan | 85.82 | 86.96 | 84.37 | 87.27 | 85.65 | 93.65 |
| BiLSTM Olmadan | 97.73 | 98.43 | 97.02 | 98.44 | 97.72 | 99.64 |
| CrossAttention Olmadan | 98.62 | 98.22 | 99.05 | 98.20 | 98.63 | 99.86 |
| ResidualFusion Olmadan | 97.49 | 97.61 | 97.37 | 97.60 | 97.49 | 99.68 |
| AdaptiveGate Olmadan | 96.65 | 99.00 | 94.27 | 99.04 | 96.58 | 99.38 |
| Attention pooling Olmadan | 97.91 | 97.63 | 98.21 | 97.60 | 97.92 | 99.57 |
Tam model ve bileşen varyantları için ablasyon değerlendirme sonuçları.
Tablo 8’deki sonuçlar, Tablo 7’deki beş katmanlı çapraz doğrulama sonuçlarından ayrı yorumlanmalıdır. Tablo 7 beş katman boyunca ortalama performansı rapor ederken, Tablo 8’deki %99,16 doğruluk, 1.671 örnek içeren ayrı bir değerlendirmeye karşılık gelir. Ayrıca, uygulanan ablasyon mimarisi önerilen Enhanced FusionNet’ten farklı olduğundan, bu sonuçlar önerilen tam mimarinin doğrudan, kontrollü bir ablasyonunu oluşturmaz. Raporlanan bileşen düzeyindeki performans yorumlanırken bu ayrımlar dikkate alınmalıdır.
4.5 Öğrenilen temsil özelliklerinin analizi
t-SNE görselleştirmesi, öğrenilen özellik alanında sınıf bazında bir örgütlenmenin niteliksel kanıtını sunmaktadır. Gerçek ve sahte örnekler arasındaki gözlemlenen ayrışma, değerlendirilen veri seti altında öğrenilen temsillerin yapısını ortaya koymaktadır; ancak t-SNE doğrusal olmayan bir görselleştirme tekniğidir ve sınıflandırıcının geçerliliği, dayanıklılığı, konuşmacıdan bağımsız genelleme ya da veri setleri arası performans açısından bağımsız bir kanıt olarak yorumlanmamalıdır.
Şekil 6’da kümeler arasındaki ortalama ayrışma, önceki bölümlerde sunulan nicel performans sonuçlarıyla uyum içindedir ve önerilen Enhanced FusionNet’in güvenilir sahte konuşma tespitinde sağlam bir özellik temsili kazandığına dair nitiesel kanıt işlevi görmektedir.
Şekil 6
4.6 RAVDESS duygu kodlayıcısı ve konuşmacıdan bağımsız değerlendirme
Önerilen çerçevede kullanılan duygu temsili değerlendirmek amacıyla, konuşmacıdan bağımsız bir duygu kodlayıcısı eğitilmiş ve RAVDESS veri setinde değerlendirilmiştir. Kodlayıcı, görünmeyen konuşmacılar üzerinde %61,51 doğruluk ve %59,81 makro-F1 elde ederek, öğrenilen temsilin duyguyla ilişkili özellikleri yakaladığını ancak aynı zamanda konuşmacılar arası duygu tanımının zorluklarını da yansıttığını göstermektedir. Sonuçlar, öğrenilen duygu temsilinin FoR sahte konuşma tespit çerçevesine aktarımı için kontrollü bir temel sağlamaktadır.
Şekil 7, RAVDESS duygu kodlayıcısının eğitim dönemleri boyunca gösterdiği öğrenme davranışını ortaya koymaktadır. Eğitim kaybındaki kademeli azalma ve eğitim doğruluğundaki artış, duyguyla ilişkili örüntülerin etkili biçimde öğrenildiğini gösterirken, nispeten kararlı doğrulama performansı modelin eğitim verisinin ötesinde ölçülebilir düzeyde bir tahmin performansı koruyabilme yeteneğini yansıtmaktadır. Eğitim ve doğrulama eğrileri arasındaki gözlemlenen fark, aynı zamanda duygu temsillerinin farklı konuşmacılar arasında aktarımının zorluğunu da vurgulamaktadır.
Şekil 7
Şekil 8, konuşmacıdan bağımsız test kümesinde RAVDESS duygu kodlayıcısının karışıklık matrisini sunmaktadır. Çizgi üzerindeki değerler, öfke, tiksinme, korku ve şaşkınlık gibi duygulara karşı nispeten daha güçlü bir tanıma gösterirken, sakin, mutlu, nötral ve üzgün duygular için daha fazla karışıklık gözlemlenmektedir. Özellikle sakin örnekler sık sık nötral olarak sınıflandırılırken, korku örnekleri şaşkınlıkla karışıklık göstermektedir. Genel olarak matris, duygu tanımasında sınıfa bağlı değişkenliği ortaya koymakta ve görünmeyen konuşmacılar arasında akustik açıdan benzer duygu kategorilerini ayırt etmenin zorluğunu vurgulamaktadır.
Şekil 8
Şekil 9, sekiz duygu kategorisi arasında belirgin F1-skoru değişkenliğini göstermektedir. En yüksek F1-skorları öfke ve şaşkınlık için gözlemlenmekte, bu duyguların nispeten tutarlı bir şekilde tanındığını gösterirken; mutlu ve nötral daha düşük F1-skorları göstermekte ve görünmeyen konuşmacılar üzerinde bu kategorilerin ayırt edilmesinde daha fazla zorluğun olduğunu yansıtmaktadır. Tiksinme, korku ve üzgün dahil kalan diğer duygular ara düzeyde performans sergilemektedir. Genel olarak sonuçlar, duygu kodlayıcısının farklı duygusal özellikleri sınıflar arasında değişken etkinlikle yakaladığını, bu durumun konuşmacıdan bağımsız karışıklık matrisinde gözlemlenen sınıfa ait desenlerle uyumlu olduğunu göstermektedir.
Şekil 9
4.7 Aktarılan duygu temsili için kontrollü değerlendirme
Geçirilen duygu temsilinin katkısını izole etmek için, aynı değerlendirme protokolü altında (Tablo 9) yalnızca FoR yapılandırması ile karşılık gelen FoR + Duygu yapılandırması karşılaştırılarak kontrollü bir soyutlama deneyi gerçekleştirildi. Sonuçlar, 128 boyutlu duygu temsilinin giriş boyutunu 1.016’dan 1.144’e değiştirdiğini göstermektedir. Yalnızca FoR yapılandırması %98,67 doğruluk elde ederken, FoR + Duygu yapılandırması %98,42 doğruluk elde etti. Duygu özelliklerinin eklenmesi hassasiyet ve özgüllüğü biraz iyileştirse de, duyarlılık, F1-skoru ve ROC-AUC’da küçük düşüşlere yol açtı. Bu nedenle, mevcut deney protokolü altında geçirilen duygu temeli tamamlayıcı bilgi sağlamakta, ancak sahte konuşma tespit performansında genel bir iyileştirme üretmemektedir. Bu kontrollü sonuç, duygusal bilginin spesifik katkısını, tespit performansını yalnızca artan özellik boyutuna bağlamadan açıklamaktadır.
Tablo 9
| Model yapılandırması | Giris boyutu | Doğruluk (%) | Hassasiyet (%) | Duyarlılık (%) | Özgüllük (%) | F1-skoru (%) | ROC-AUC (%) | FAR (%) | FRR (%) | EER (%) |
|---|---|---|---|---|---|---|---|---|---|---|
| Yalnızca FoR | 1,016 | 98.67 | 98.18 | 99.17 | 98.16 | 98.67 | 99.88 | 1.84 | 0.83 | 0.83 |
| FoR + duygu | 1,144 | 98.42 | 98.50 | 98.33 | 98.50 | 98.42 | 99.54 | 1.50 | 1.67 | 1.50 |
| Δ (duygu − FoR) | +128 | −0.25 | +0.31 | −0.83 | +0.33 | −0.26 | −0.34 | −0.33 | +0.83 | +0.67 |
Geçirilen duygu temsilinin kontrollu soyutlaması.
4.8 Sınıflandırma hatası ve hata analizi
Hata analizi, beş katlı çapraz doğrulama deneyinden elde edilen tam out-of-fold tahminleri kullanılarak gerçekleştirildi. Analiz, her bir örnek dış test katında bir kez değerlendirilecek şekilde tüm 8.358 FoR konuşma örneğini kapsamıştır. İlgili sonuçlar Tablo 10’da özetlenmiştir.
Tablo 10
| Ölçü | Değer |
|---|---|
| Toplam değerlendirilen örnek | 8.358 |
| Doğru tahmin | 8.281 |
| Yanlış sınıflandırılan örnek | 77 |
| Doğruluk (%) | 99,08 |
| Hata oranı (%) | 0,92 |
| Yalancı pozitif | 52 |
| Yalancı negatif | 25 |
Hata analizi özeti.
Önerilen Enhanced FusionNet, 8.281 örneği doğru sınıflandırmış ve 77 örneği yanlış sınıflandırmıştır; bu da toplamda %99,08 doğruluk ve %0,92 hata oranı vermiştir. Model 52 yalancı pozitif ve 25 yalancı negatif tahmin üretmiştir. Görece küçük sayıda yanlış sınıflandırılan örnek, hataların çoğunun gerçek ve sentetik konuşmanın özelliklerinin örtüşebileceği, sesbilgisel açıdan zorlu durumlarda ortaya çıktığını göstermektedir. Ancak bu sonuçlar, değerlendirilen FoR veri kümesi içinde yorumlanmalı ve veri kümesi ya da konuşmacıdan bağımsız genelleme açısından doğrudan kanıt olarak değerlendirilmemelidir.
Tablo 10’da out-of-fold tahminlerinden elde edilen karışıklık matrisi [(4.115, 52), (25, 4.166)] şeklinde olup, 4.115 gerçek örneğin doğru şekilde gerçek, 4.166 sahte örneğin ise doğru şekilde sahte olarak sınıflandırıldığını göstermektedir. Geriye kalan 52 gerçek örnek sahte olarak, 25 sahte örnek ise gerçek olarak hatalı şekilde sınıflandırılmıştır. Bu hatalar, modelin çapraz doğrulama sırasında karşılaştığı zorlu karar durumlarını temsil etmektedir (Tablo 11).
Tablo 11
| Numune indeksi | Gerçek etiket | Tahmin edilen etiket | Güven |
|---|---|---|---|
| 59 | Gerçek | Sahte | 0.9080 |
| 700 | Gerçek | Sahte | 0.9541 |
| 374 | Sahte | Gerçek | 0.0581 |
| 592 | Sahte | Gerçek | 0.0500 |
| 1881 | Sahte | Gerçek | 0.4481 |
Temsili yanlış sınıflandırılmış örnekler.
4.9 Güvenlik odaklı performans değerlendirmesi
Konvansiyonel sınıflandırma metriklerinin yanı sıra, önerilen Enhanced FusionNet, tam katman dışı (out-of-fold) tahminlerden türetilmiş güvenlik odaklı ölçütle de değerlendirildi. Model %99,403 duyarlılık, %98,752 duyarsızlık, %1,248 yanlış kabul oranı (FAR), %0,597 yanlış reddetme oranı (FRR) ve %0,909 eşit hata oranı (EER) elde etti. Bu sonuçlar, modelin sahte konuşmayı algılama yeteneğine, yanlış kabul ve yanlış reddetme hatalarını denetlerken daha detaylı bir değerlendirme sunmaktadır. Göreceli olarak düşük FAR ve FRR, değerlendirilen FoR protokolü altında gerçek ve sahte konuşmaların sınıflandırılmasındaki hataların sınırlı olduğunu göstermektedir. Ancak bu metrikler veri setine bağlıdır ve tam ses biyometrik sahte konuşma algılama sisteminde doğrudan performans kanıtı olarak yorumlanmamalıdır. Tablo 12.
Tablo 12
| Metrik | Değer (%) |
|---|---|
| Duyarlılık/geri çağırma | 99.403 |
| Duyarsızlık | 98.752 |
| FAR | 1.248 |
| FRR | 0.597 |
| EER | 0.909 |
Önerilen gelişmiş FusionNet’in güvenlik odaklı performansı.
4.10 Hesaplama karmaşıklığı ve performans karşılaştırması
Önerilen Enhanced FusionNet’in hesaplama karmaşıklığı, eğitilebilir parametreleri ve sınıflandırma performansı, uygulanan temel modellerle karşılaştırılarak değerlendirildi. Karşılaştırma Tablo 13’te sunulmaktadır. Değerlendirilen temel modeller, önerilen mimariye göre önemli ölçüde daha az eğitilebilir parametre içermekte, 2.882 ile 67.747 parametre arasında değişmektedir. Buna karşılık, önerilen Enhanced FusionNet 976.779 eğitilebilir parametre içermekte; bu durum, çok ölçekli convolusyon, zamanlı modelleme, çapraz dikkat, artıksal özellik birleştirme ve uyarlamalı kapama tarafından getirilen ek hesaplama gereksinimlerini yansıtmaktadır.
Tablo 13
| Model | Model türü | Parametreler | Doğruluk (%) | İsabetlilik (%) | F1-skoru (%) | ROC-AUC (%) |
|---|---|---|---|---|---|---|
| CNN temel | Temel | 48.322 | 93,38 | 93,61 | 93,39 | 98,10 |
| CNN–BiLSTM–dikkat temeli | Temel | 67.747 | 91,39 | 89,17 | 91,65 | 97,19 |
| Enhanced FoRNet | Temel | 5.494 | 92,03 | 91,14 | 92,14 | 97,42 |
| Hafif 1D CNN | Temel | 2.882 | 72,49 | 69,09 | 74,87 | 82,39 |
| Enhanced FusionNet | Önerilen | 976.779 | 98,67 | 98,18 | 98,67 | 99,88 |
Hesaplama karmaşıklığı ve performans karşılaştırması.
Tablo 13’te, önerilen Enhanced FusionNet 976.779 eğitilebilir parametre içermekte ve bağımsız 1.199 örneklik ayırma test kümesinde %98,67 doğruluk, %98,18 kesinlik, %98,67 F1 skoru ve %99,88 ROC-AUC elde etmiştir. Bu sonuçlar, önerilen mimarinin belirtilen ayırma değerlendirme protokolü altındaki tahmin performansını karakterize etmektedir. Daha büyük parametre sayısı, uygulanan temel modellerle karşılaştırıldığında ek hesaplama gereksinimlerini işaret etmektedir; dolayısıyla model, yalnızca tahmin performansına dayanarak hesaplama verimli olarak tanımlanmamaktadır. Gerçek zamanlı yerleştirme uygunluğunun değerlendirilmesi için çıkarım gecikmesinin, bellek tüketiminin ve veri akış hızının ayrıca değerlendirilmesi gerekecektir.
5 Tartışma
Deneysel sonuçlar, Enhanced FusionNet’in değerlendirilen FoR protokollerinde gerçek ve sentetik konuşmayı etkili biçimde ayırt ettiğini göstermektedir. Bağımsız ayırma değerlendirmesi %98,67 doğruluk, %98,67 F1 skoru ve %99,88 ROC-AUC elde ederken, beş katlı çapraz doğrulama %99,08 ± 0,35% doğruluk ve %99,94 ± 0,05% ROC-AUC elde etmiştir. İnceleme sonuçları, mimari bileşenlerin farklı oranlarda katkı sağladığını ve MultiScaleCNN’in en büyük performans değişimini ürettiğini göstermektedir. Konuşmacıdan bağımsız RAVDESS deneyi, öğrenilen duygu temsilinin bağımsız bir değerlendirmesini sağlamıştır; ancak kontrollü yalnızca FoR ile FoR + Duygu deneyi genel bir tespit iyileşmesi göstermemiştir. Bu nedenle duygu bilgisinin tamamlayıcı, performans artırıcı olmayan bir unsur olarak değerlendirilmektedir. Tutarsız konuşmacı kimliklerinin kullanılamaması, kayıt koşulları, kanal özellikleri ve sentetik özgü artefaktları dahil olmak üzere veri setiyle ilgili faktörler sonuçları etkileyebilir. Bu nedenle bildirilen performans, evrensel veya konuşmacıdan bağımsız genelleşme kanıtı olarak değil, değerlendirilen FoR protokolü içinde yorumlanmalıdır. Gelecek çalışmalar, görünmeyen sentetik yöntemleri, dış veri setlerini, çok dilli ve gürültülü konuşmayı, güncel anti-dolandır mimarilerini ve yerleştirme odaklı hesaplama gereksinimlerini değerlendirmelidir.
6 Etik değerlendirmeler ve sorumlu yerleştirme
Bu çalışmada yalnızca halka açık FoR ve RAVDESS veri setleri, ilgili lisans ve kullanım koşullarına uygun olarak kullanılmıştır. Veri setlerinde kişisel olarak tanımlanabilir bilgi bulunmamakta ve RAVDESS, yaratıcılarının bildirdiği gibi katılımcı onayı ile araştırma amaçlı toplanmıştır. Yeni insan katılımcı alınmamış veya ek kişisel veri toplanmamıştır; bu nedenle ek kurumsal etik onayı gerekli değildir. Önerilen çerçeve sentetik konuşma tespiti’ni desteklemeyi amaçlasa da, duygu bilincili analiz yanlış kullanıldığında gizlilik kaygıları doğurabilir. Bu nedenle, böyle sistemler yalnızca kimlik doğrulama, dolandırıcılık tespiti ve dijital adli bilişim uygulamaları gibi yetkili amaçlar için, geçerli veri koruma ve etik gereksinimlere uyularak konuşlandırılmalıdır. Gelecek araştırmalar, sorumlu konuşlandırma için gizliliği koruyan ve saldırganlara dayanıklı yaklaşımları daha ileri düzeyde incelemelidir.
7 Sonuç
Bu çalışma, çok ölçekli evrişimli işleme, zamanlı modelleme, çapraz dikkat, artıklı özellik birleştirme, uyarlamalı kapama ve dikkat tabanlı havuzlama ile derin sahtecilik ses tespiti için Enhanced FusionNet’i sunmaktadır. Model, bağımsız ayırma testleri, katmanlı beş-förlü çapraz doğrulama, bileşen düzeyinde kırpma analizi, güvenlik odaklı ölçümler ve istatistiksel belirsizlik analiziyle değerlendirilmiştir. Aktarılan RAVDESS duygu temsili, konuşmacıdan bağımsız bölütleme kullanarak ayrı olarak öğrenilmiş ve kontrollü yalnızca FoR ile FoR + Duygu deneyi üzerinden değerlendirilmiştir. Sonuçlar, duygu temsili tamamlayıcı bilgi sağladığını ancak değerlendirilen protokolle tespit performansında genel bir iyileşme getirmediğini göstermektedir. Tutarlı FoR konuşmacı kimliklerinin mevcut olmaması ve dışarıdan görülmemiş üretim değerlendirmesinin yapılmaması nedeniyle, bulgular evrensel veya konuşmacıdan bağımsız genelleme kanıtı değil, derin sahtecilik ses tespiti için temel düzeyinde sonuçlar olarak yorumlanmalıdır. Gelecek çalışmalar, veri seti çapraz doğrulama, görülmemiş sentez yöntemleri, güncel anti-spoofing mimarileri, çok dilli ve gürültülü koşullar ve dağıtım odaklı hesaplama değerlendirmesine odaklanmalıdır.
Açıklamalar
Veri erişilebilirliği açıklaması
Çalışmada sunulan özgün katkılar makale/ekle malzemesinde yer almaktadır; daha ileri başvurular ilgili yazar’a yöneltilebilir.
Finansman
Yazar(lar), bu çalışma ve/veya yayımı için finansal destek alınmadığını beyan etmiştir.
Çıkar çatışması
Yazar(lar), bu çalışmanın olası bir çıkar çatışması olarak değerlendirilebilecek herhangi bir ticari veya finansal ilişki olmadan yürütüldüğünü beyan etmiştir.
Üretken yapay zekâ açıklaması
Yazar(lar), bu metnin oluşturulmasında Üretken Yapay Zekâ kullanılmadığını beyan etmiştir.
Bu makalede şekillerle birlikte sağlanan alternatif metinler (alt text) Frontiers tarafından yapay zekânın desteğiyle oluşturulmuş ve mümkün olduğunca yazarların gözden geçirmesini de içeren makul çabalarla doğruluğunun sağlanması için uğraşılmıştır. Herhangi bir sorunu tespit ederseniz, lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarların görüşlerini yansıtır ve mutlaka bağlı oldukları kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini temsil etmez. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
-
ArcotS. V.PalavesamK. V.KrishnamoorthyM. V. (2025). Contact center’da ses biyometrisi: güvenlik ve müşteri deneyiminin dönüştürülmesi. Int. J. Innov. Sci. Res. Technol.13:14730627. doi: 10.5281/zenodo.14730627
- CrossRef
- Google Scholar
-
ChenX.ZhangY.ZhuG. (2021). ASVspoof 2021 için kanal-robus sentetik ses tespit sistemi. arXiv2107:12018. doi: 10.48550/arXiv.2107.12018
- CrossRef
- Google Scholar
-
ContiE.PompiliD. (2022). Duygu tanıma yoluyla deepfake ses tespiti. ICASSP2022:9746583. doi: 10.1109/ICASSP43922.2022.9746583
- CrossRef
- Google Scholar
-
ContiE.SalviD.BorrelliC.HoslerB.BestaginiP.AntonacciF. ve ark. (2022). “Duygu tanıma yoluyla deepfake ses tespiti: bir anlam yaklaşımı,” ICASSP 2022–2022 IEEE International Conference on Acoustics, speech and signal Processing (ICASSP) içinde, (New York: IEEE).
- Google Scholar
-
DasR. K. (2021). “Mantıksal erişim, fiziksel erişim ve ses deepfake saldırılarının tespit edilmesi için bilinen-bilinmeyen veri artırma stratejileri: ASVspoof 2021,” 2021 Automatic Speaker Verification and Spoofing Countermeasures Challenge içinde, ().
- Google Scholar
-
Delgado H, Todisco M, Evans N. (2022). Wav2Vec 2.0 ve veri artırma kullanılarak otomatik konuşmacı doğrulama sahteciliği ve Deepfake tespiti. Odyssey 2202, 112–119. doi: 10.48550/arXiv.2202.12233
- CrossRef
- Google Scholar
-
Firc A, Malinka K, Hanáček P. (2025). Deepfake ses tespiti için değerlendirme çerçevesi: güncel deepfake ses dedektörlerinin karşılaştırmalı çalışması. Cybersecurity 8:50. doi: 10.1186/s42400-024-00346-1
- CrossRef
- Google Scholar
-
Gupta P, Patil H A, Guido R C. (2024). Otomatik konuşmacı doğrulama (ASV) sistemlerindeki güvenlik açıkları. Eurasip J. Audio Speech Music Process. 1:5. doi: 10.1186/s13636-024-00313-5
- CrossRef
- Google Scholar
-
Hosler B, Wang Y. (2021a). Deepfakes duyguları yeterince yansıtıyor mu? CVPR Workshops 2021:312. doi: 10.1109/CVPRW53098.2021.00312
- CrossRef
- Google Scholar
-
Hosler B, Wang Y. (2021b). Ses Deepfakes’lerinin tespitinde mikro-duygusal göstergeler. J. Voice 36, 134–139. doi: 10.1016/j.jvoice.2020.03.017
- Pubmed Abstract
- CrossRef
- Google Scholar
-
Jadhav A P, Manakhari S S. (2024). “Akıllı ev güvenliğinin artırılması: IoT cihazlarında K-en yakın komşu kullanan sağlam ses doğrulama çerçevesi,” in World Congress in Computer Science, Computer Engineering and Applied Computing, (Cham: Springer Nature Switzerland), 273–285.
- Google Scholar
-
Janeja V P. (2022). Ses deepfakes: bir derleme. Front. Big Data 5:1001063. doi: 10.3389/fdata.2022.1001063
- Pubmed Abstract
- CrossRef
- Google Scholar
-
Javed A, Malik K M, Malik H, Irtaza A. (2022). Ses sahteciliği dedektörü: birleşik anti-spoofing çerçevesi. Expert Syst. Appl. 198:116770. doi: 10.1016/j.eswa.2022.116770
- CrossRef
- Google Scholar
-
Jia ve ark. (2018). Konuşmacı doğrulamasından çok konuşmacılı metin-okuma sentezine aktarımlı öğrenme. NeurIPS 2018, 4480–4490.
- Google Scholar
-
Kumar ve ark. (2019). MelGAN: koşullu dalgalanma sentez için üretimsel çatışmalı ağlar. NeurIPS, 14910–14921. Çevrimiçi erişim: https://arxiv.org/abs/1910.06711
- Google Scholar
-
Li M. Ahmadiadli Y. Zhang X.-P. (2025). Konuşma sahteciliği tespiti üzerine bir derleme. ACM Comput. Surv. 57, 1–38. doi: 10.1145/3714458,
- Pubmed Abstract
- CrossRef
- Google Scholar
-
Li X. Chen P.-Y. Wei W. (2025). Ses sahteciliği tespitinde neredeyiz? Üretimsel ve tespit modelleri üzerinden sistematik analiz. ACM Trans. Internet Technol. 25, 1–19. doi: 10.1145/3736765
- CrossRef
- Google Scholar
-
Li H. Wu Z. Li X. (2020). Ses sahteciliği tespiti: bir derleme. arXiv 2007:e03562. doi: 10.48550/arXiv.2007.03562
- CrossRef
- Google Scholar
-
Li D. Yang Z. Liu J. Yang H. Wang Z. (2024). Konuşmacı tanıması için duygusal öz-dikkat mekanizması içeren duygusal gömme çerçevesi. Expert Syst. Appl. 238:122244. doi: 10.1016/j.eswa.2023.122244
- CrossRef
- Google Scholar
-
Liu X. Wang X. Yamagishi J. (2022). ASVspoof 2021: sahteleştirilmiş ve sahtecilik konuşma tespiti için. IEEE/ACM Trans. Audio Speech Lang. Process. 31:3285283. doi: 10.1109/TASLP.2023.3285283
- CrossRef
- Google Scholar
-
Ma H. Yi J. Wang C. Yan X. Tao J. Wang T. ve ark. (2024). CFAD: sahte ses tespiti için bir Çin veri seti. Speech Comm. 164:103122. doi: 10.1016/j.specom.2024.103122
- CrossRef
- Google Scholar
-
Masood M., Nawaz M., Malik M., Javed K. M., Irtaza A., Malik A., H. (2023). Deepfakes generation and detection: state-of-the-art, open challenges, countermeasures, and way forward: deepfakes generation and detection: state-of-the-art, open challenges, countermeasures, and way forward. Appl. Intell. 53, 3974–4026.
- Google Scholar
-
Moorthy S., Moon Y.-K. (2025). Hybrid multi-attention network for audio–visual emotion recognition through multimodal feature fusion. Mathematics 13:1100. doi: 10.3390/math13071100
- CrossRef
- Google Scholar
-
Morrison G. S., Enzinger E. (2016). Multi-laboratory evaluation of forensic voice comparison systems under conditions reflecting those of a real forensic case (forensic_eval_01)–introduction. Speech Comm. 85, 119–126. doi: 10.1016/j.specom.2016.07.006
- CrossRef
- Google Scholar
-
Nguyen B., Shi S., Ofman R., Le T. (2025). “What you read isn’t what you hear: linguistic sensitivity in deepfake speech detection,” in Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing, ().
- Google Scholar
-
Ogenyi F. C., Ugwu C. N., Ugwu O. P.-C. (2025). Securing the future: AI-driven cybersecurity in the age of autonomous IoT. Frontiers in the Internet of Things 4:1658273. doi: 10.3389/friot.2025.1658273
- CrossRef
- Google Scholar
-
Panayotov V. et al. (2015). Librispeech: An ASR Corpus Based on Public Domain Audio Books. New York: IEEE.
- Google Scholar
-
Pepino L., Riera P., Ferrer L., Gravano A. (2020). “Fusion approaches for emotion recognition from speech using acoustic and text-based features,” in ICASSP 2020–2020 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), (New York: IEEE).
- Google Scholar
-
ShinH.-S.HeoJ.YuH.-J. (2023). HM-conformer: ses tabanlı sahte içerik tespiti için conformer temelli bir sistem. arXiv2024:10448453. doi: 10.1109/ICASSP48485.2024.10448453
- CrossRef
- Google Scholar
-
SimK. S.IslamM. T. (2026). Sahte içerik tespiti ve dijital medya kimlik doğrulama için çok modlu dönüştürücü temelli filigranlama: güncel ilerlemeler, zorluklar ve geleceğe yönelik yönler. Front. Artificial Intelligence9:1848963. doi: 10.3389/frai.2026.1848963,
- Pubmed Abstract
- CrossRef
- Google Scholar
-
TakH.PatinoJ.TodiscoM.NautschA.EvansN.LarcherA. (2021). “Ham net2 ile uçtan uca sahtecilik önleme,” in ICASSP 2021–2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), (New York: IEEE).
- Google Scholar
-
TanH.WuJ. (2022). Sahte seslerde duygusal sadakat üzerine bir araştırma. Speech Comm.138, 22–34. doi: 10.1016/j.specom.2022.01.004
- CrossRef
- Google Scholar
-
UnivasoP.San SegundoE. (2025). Gerçekçi adli ses karşılaştırması senaryolarında klonlanmış seslerin tespiti. Front. Artificial Intelligence8:1678043. doi: 10.3389/frai.2025.1678043,
- Pubmed Abstract
- CrossRef
- Google Scholar
-
VarianiE.et al. (2014). Küçük İz Alan Metin-Bağlı Konuşmacı Doğrulama için Derin Sinir Ağları. New York: IEEE.
- Google Scholar
-
WuZ.et al. (2020). ECAPA-TDNN: TDNN temelli konuşmacı doğrulamada vurgulanmış kanal dikkati, yayılım ve birleştirme. arXiv2005:e07143. doi: 10.21437/Interspeech.2020-2650
- CrossRef
- Google Scholar
-
XingT.DouY.ChenX.ZhouJ.XieX.PengS. (2024). MDD tespiti için çok modlu özellik birleştirme öğrenmeye uygun uyarlanabilir çoklu grafik sinir ağı. Sci. Rep.14:28400. doi: 10.1038/s41598-024-79981-0,
- Pubmed Abstract
- CrossRef
- Google Scholar
-
YanZ.LiuX. (2024). “EmoFake: an initial dataset for emotion fake audio detection,” in Proceedings of the 2024 International Conference on Computational Linguistics, ().
- Google Scholar
-
YeJ.YanD.FuS.MaB.XiaZ. (2025). One-class network leveraging spectro-temporal features for generalized synthetic speech detection. Speech Comm.169:103200. doi: 10.1016/j.specom.2025.103200
- CrossRef
- Google Scholar
-
YiJ.WangC.TaoJ.ZhangX.ZhangC. Y.ZhaoY. (2023). Audio deepfake detection: a survey. arXiv2308:14970. doi: 10.48550/arXiv.2308.14970
- CrossRef
- Google Scholar
-
ZhangB.CuiH.NguyenV.WhittyM. (2025). Audio deepfake detection: what has been achieved and what lies ahead. Sensors25:1989. doi: 10.3390/s25071989,
- Pubmed Abstract
- CrossRef
- Google Scholar
-
ZhangR.YanZ.DengR. H. (2026). SeVoAuth: secure voiceprint authentication with hash-based feature transformation. IEEE Trans. Dependable Secure Comput.23, 7157–7173. doi: 10.1109/TDSC.2026.3671663
- CrossRef
- Google Scholar
Özet
Anahtar Kelimeler
ses özelliği birleştirmesi, duygu bilincine dayalı temsil, gelişmiş FusionNet, ses sahteciliğine karşı koruma, ses biyometrik güvenlik
Başvuru
Anumula B ve Turukmane AV (2026) Enhanced FusionNet: a deep learning structure for multimodal input-based emotion-aware deepfake speech identification. Front. Artif. Intell. 9:1978052. doi: 10.3389/frai.2026.1978052
Başvuru Tarihi
25 Ağustos 2026
Düzeltme Tarihi
14 Ekim 2026
Kabul Tarihi
26 Ekim 2026
Yayınlanma Tarihi
13 Kasım 2026
9 – 2026
Jichao Bi, Zhejiang Institute of Industry and Information Technology, China
Pedram Amini, Amirkabir University of Technology, Iran
Evans Kotei, Kumasi Polytechnic, Ghana
© 2026 Anumula ve Turukmane.
Bu, Creative Commons Atıf Lisansı (CC BY) koşulları altında açık erişimli olarak dağıtılan bir makaledir. Orijinal yazar(lar)ın ve telif hakkı sahib(lar)ının isimlendirilmesi ve bu dergideki orijinal yayının atıf edilmesi şartıyla, kabul edilen akademik uygulayışa uygun olarak bu makale diğer platformlarda kullanılabilir, dağıtılabilir veya çoğaltılabilir. Bu koşullara uymayan herhangi bir kullanım, dağıtım veya çoğaltmaya izin verilmez.
*İletişim: Anil V. Turukmane, anil.turukmane@vitap.ac.in
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların ya da yayıncının, editörlerin ve hakemlerin görüşlerini zorunlu olarak yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti altına alınmaz veya desteklenmez.
Yorumlar