İnsan Formlu Hareket Politikasında Derecelendirilmiş Tek Taraflı Motor Komutu Zayıflatmasi İçin Nicel Düşme Eşiği
Fiziksel simülasyonlarda öğrenilen insan benzeri (humanoid) robotlar için geliştirilen lokomosi (hareket) politikaları genellikle tüm aktüatörler ve…
OJİNAL ARAŞTIRMA makalesi
Front. Robot. AI, 11 Kasım 2026
Sek. Humanoid Robotik
Cilt 13 – 2026 | https://doi.org/10.3389/frobt.2026.1959239
- KO
Kenshi Obaru † *
-
rehabiliworld, Kumamoto, Japonya
Makale ölçütleri
Özet
Fiziksel simülasyonlarda öğrenilen insan benzeri (humanoid) robotlar için geliştirilen lokomosi (hareket) politikaları genellikle tüm aktüatörler ve komut kanalları tam olarak korunarak değerlendirilir; ancak bu politikaların yeniden eğitilmeden tek taraflı motor komutu bozulmasına ne kadar dayanabildikleri nadiren nicelendirilir. Bu sorunu, Unitree G1 humanoid model için bağımsız olarak eğitilmiş sekiz öngörülü (feedforward) lokomosi politikası kullanarak tamamen fiziksel simülasyon içinde ele aldık. Vücudun bir tarafındaki tüm 13 aktüatize eklemin çıkış katmanı ağırlıklarını ve önyapılarını (bias) ortak bir α çarpanıyla azalttık; bu çarpan, o taraftaki varsayılan duruştan sapma komutunu tam olarak α oranında ölçeklendirirken tork sınırları ve eklem sertliğini değiştirmedi. Yeniden eğitim gerçekleştirilmedi. Pelvis (robotun kök gövdesi) eğiliminin 5 saniye içinde 70°’yi aştığı düşmeler, α yaklaşık 0,75’ten 0,55’e düştükce keskin biçimde arttı. 0,5 m/s hızında tek seferlik taramalarda, politika başına eşikler sağ taraf azalmasında %65 ile %75, sol taraf azalmasında ise %60 ile %70 arasında değişti ve sağ taraf 8 politikanın 6’sında daha kırılgandı; tersi yönde ise hiç yoktu (kesin işaret testi, p = 0,031). Politika başına 10 rastgele koşul altında tekrarlanan denemeler, politika içi belirgin değişkenlik gösterdi ve sağ taraf azalmasında ortanca %50 düşme eşiği %68,4 (%95 IG %66,4–%70,1), sol taraf azalmasında ise %64,6 (%62,6–%66,6) olarak bulundu (sağ taraf 8 politikanın 7’sinde daha yüksekti; Wilcoxon p = 0,039). Dört yürüyüş hızı boyunca grup düzeyinde sağ taraf eşiği asla sol taraftan düşük değildi, ancak politika başına asimetri yalnızca 0,5 m/s’de anlamlı hale geldi. Düşme anında, eklem açıları önceki ≈0,6 saniye içinde varsayılan duruşa yaklaşılmaksızın kademeli olarak ona uzaklaştı. Bu sonuçlar, öğrenilen humanoid lokomosi politikasının tek taraflı komut-bozulması dayanıklılık marjının, değişkenliğe duyarlı ve tekrarlanabilir bir ölçüsünü sunar. Bozulma, inme sonrası vücudun bir tarafında ani güç kaybı olan akut hemiparezi, yani toparlanma veya yeniden öğrenme öncesindeki durum tarafından yönlendirildi; ancak bu hesaplama benzetmesidir ve insan inmesinin bir modeli değildir.
1 Giriş
Derin pekiştirmeli öğrenme, bacaklı ve insan formundaki robotlar için sağlam hareket kontrolcüleri üretmekte; bunlar genellikle devasa paralel fizik simülasyonlarıyla eğitilip donanıma aktarılmakta (Hwangbo et al., 2019; Lee et al., 2020; Rudin et al., 2022; Radosavovic et al., 2024) ve artan ölçüde bir çalışma da hareketi gösterimlerden öğrenmektedir (Mirza ve Singh, 2025). Bu politikalar yaygın olarak yakın politikanın optimize edilmesi (Schulman et al., 2017) ile MuJoCo (Todorov et al., 2012) gibi simülasyonlarda, giderek artan biçimde mjlab (Zakka et al., 2026) gibi GPU hızlandırmalı çerçeveler aracılığıyla eğitilmektedir. Ancak değerlendirmeleri genellikle tüm aktörlerin ve komut kanallarının amaçlandığı gibi çalıştığı varsayımına dayanmaktadır.
Eğitilen kontrolcülerin sağlamlığı, başlıca politikaları eğitim sırasında değişkenliğe maruz bırakarak elde edilmektedir; örneğin dinamik rastgeleleştirme (Peng et al., 2018) ya da bir robotın hasar sonrası uyum sağlamasına izin vererek (Cully et al., 2015). Eğitilen, uyum sağlamamış bir politikanın kendi motor komutlarının bir bölümü zayıflatıldığında nasıl bozulduğu ve özellikle belirli bir sınıra ulaştığında başarısız olup olmadığı konusunda ise çok daha az şey bilinmektedir. Genel olarak eğitilen sinir ağlarında, bir ağırlığın bu birimlere ya da yönlere ne kadar güvendiğini araştırmak için bireysel birimler ya da yönlerin yok edilmesi yerleşik bir yöntemdir (Morcos et al., 2018). Bu yaklaşım, burada kullanılan politika ailesine iki eş çalışma uygulamıştır: biri tek eklemelerin çıkış birimini yok etmiş (Obaru, 2026a), diğeri ise propioseptif girdileri kaldırmıştır (Obaru, 2026b). Bu çalışmanın yorumlanmasında gereken tüm yöntemler burada ve Ek Malzeme S4’te tanımlanmaktadır; böylece bağımsız biçimde okunabilmektedir.
Bu çalışmada, eğitilmiş bir humanoid yürüme politikasının, vücudun tamamına giden motor komutlarının dereceli ve eşzamanlı zayıflatılmasını düşmeye neden olmadan ne kadar tolere edebildiği; bu marjın politika-politika ve politika-içi değişkenlik hesaba katıldığında ne kadar kesin tahmin edilebildiği; ve bunun sol ve sağ taraf arasında ile yürüme hızları arasında fark gösterip göstermediği soruları soruluyor. Bozulma tasarımı, ani hemiparezi ile motive edilmiştir; bu durumda vücudun bir tarafı, herhangi bir motor yeniden öğrenme gerçekleşmeden önce aniden zayıflatılır. Kas-iskelet simülasyon çalışmalarının aksine, zayıflık getirildikten sonra kontrolcü yeniden optimize edilmez veya yeniden eğitilmez (Ong et al., 2019; Falisse et al., 2020; Choi et al., 2026); hiçbir yeniden eğitim yapılmaz. Klinik terimi yalnızca bu tasarımı motive etmek için kullanılmaktadır: akut evredeki bir hastaya benzer şekilde, adapte olmamış politika, ani bir tek taraflı eksiklikle zaten sahip olduğu kontrol stratejisiyle baş etmek zorundadır. Başta vurgulamamız gerekir ki bu hesaplama temelli bir benzetmedir: zayıflatma komut genliğini kas gücü yerine ölçeklendirir (Bölüm 2.2) ve sonuçlar bir insan inme modelinin özellikleri değil, bir robot kontrol politikasının özellikleridir. Ayrıca düşme üreten kontrol başarısızlığına odaklanmamız ile, resulting düşmenin kinematiğini biyomekanik veya yaralanma analizi için karakterize eden çalışmalar (Ferrari et al., 2026) arasındaki farkı da belirtiyoruz.
2 Malzemeler ve yöntemler
2.1 Robot modeli, kontrol politikaları ve eğitim
Tüm deneyler tamamen simülasyon içinde gerçekleştirilmiştir; MuJoCo fizik motoru (sürüm 3.5.0) ve GPU uygulaması MuJoCo Warp (sürüm 3.6.0), mjlab çerçevesi (sürüm 1.2.0) aracılığıyla ve mjlab ile birlikte dağıtılan Unitree G1 robot modeli kullanılarak yürütülmüştür. Hiçbir aşamada fiziksel robot donanımı kullanılmamıştır. Model (g1_29dof_rev_1_0) 29 aktüeli eklem (12 bacak, 3 bel ve 14 kol eklemi) ve toplam 33,3 kg kütleye sahiptir. Her eklem, 5–139 N·m tork limitlerine sahip konum kontrollü bir PD aktüatörü ile sürülmüştür. Kontrol politikaları Unitree’ninki değildir; simülasyon içinde güçlendirilmiş öğrenme ile yazar tarafından eğitilmişlerdir.
Sekiz politika, PPO kullanılarak mjlab hız takibi görevinde (Mjlab-Velocity-Flat-Unitree-G1) eğitildi; her biri 2.048 paralel ortam ile 3.000 yineleme boyunca yalnızca öğrenme algoritması tohumu (1–8) açısından farklılaşarak yürütüldü. Ortam tohumu 100’de, başlangıç yön açısı ise hem eğitim hem değerlendirme sırasında −90° yavşakta sabitlendi. Aktör, 99 girdili ileri beslemeli çok katmanlı algılayıcıdan (512, 256 ve 128 birimli gizli katmanlar ve ELU aktivasyonları; ampirik gözlem normalizasyonu) ve 29 birimli lineer bir çıkış katmanından oluşur. Fizik zaman adımı 0,005 s olup 4 kat azaltma ile 50 Hz kontrol frekansı sağlanır. Tam teknik özellikler, PD kazançları, eylem ölçekleri, ödül terimleri, PPO hiperparametreleri ve yazılım sürümleri Ek Malzeme S4’te; analiz defterleri Data Sheet S1’de verilmiş olup, eğitilmiş checkpoint’ler halka açık durumdadır (bkz. Veri Uygunluğu).
2.2 Tek taraflı motor komutu zayıflatması
Her bir aktör çıkış birimi j için ham eylem aj = wjTh + bj olarak hesaplanır; burada h son gizli katmanın çıkışıdır. Zayıflatma, hedeflenen her eklem için ağırlık satırı wj ve bj sapmasını aynı α çarpanıyla çarpar (kalan motor çıkışı; α = 1 değiştirilmemiş politika, α = 0 ise tam silmedir), böylece aynı ağ girişi için ham eylem tam olarak α·aj olur. Herhangi bir eylem sınırlaması uygulanmaz. Eylem, eklem pozisyonu hedefine dönüştürülür; burada q0 varsayılan (dik) duruş, sj eklem başına eylem ölçeği (0.25 × tork limiti / Kp) ve Kp, Kd ve τmax PD kazançları ve tork limitidir. Eğitiliş checkpoint’larında sayısal olarak, zayıflatılmış çıkışların orijinal çıkışların α katına eşit olduğunu (maksimum mutlak fark 5.96 × 10⁻⁸) ve zayıflatılmamış çıkışların değişmediğini (fark tam olarak 0) doğruladık. Dolayısıyla zayıflatma, komutlanan hareketin genliğini varsayılan duruşa doğru küçültür; kullanılabilir eklem torkunu azaltmaz veya PD sertliğini ve sönümünü değiştirmez. Kas gücü kapasitesindeki azalmadan çok, inen komut genliğindeki azalmaya yakındır. Kapalı çevrimde ağ girişi evrilir ve önceki (zayıflatılmış) eylem gözlem olarak geri beslenir, dolayısıyla α‘nin gerçekleşen harekete etkisi basit bir ölçekleme değildir.
Aynı α vücutun bir tarafındaki 13 aktüeli ekleme aynı anda uygulandı: 6 bacak eklemi (kalça pitch, roll ve yaw; diz; ayak bileği pitch ve roll) ve 6 kol eklemi (omuz pitch, roll ve yaw; dirsek; bilek roll, pitch ve yaw). Üç bel eklemi hiçbir zaman zayıflatılmadı. Hiçbir zayıflatma seviyesinde yeniden eğitim yapılmadı.
2.3 Değerlendirme koşulları
Bir kontrol adımı, bir politika güncellemesi anlamına gelir; yani 0,02 saniye ya da dört fizik altadımı. Her değerlendirme denemesi 250 kontrol adımı (50 Hz’de 5 saniye) sürmüş ve bu süre içinde sabit ileri yönlü hız komutu her kontrol adımında yeniden verilmiştir. Bir düşme, robotun floating-base kök gövdesi olan kalça kemiginin 70°’yi aşan eğilmesi, yani kalça kemiginin dikey ekseni ile dünya dikeyi arasında, kalça çerçevesinde ifade edilen yerçekimi vektöründen hesaplanan 70°’den fazla bir açı olarak tanımlanmıştır. Bu, görevin sonlandırma koşuludur (mjlab bad_orientation, limit açı 70°). Bu ölçüt, toparlanamaz bir denge kaybının başlangıcını işaret eder; düşmenin bu çalışmada analiz edilen iniş ve çarpma fazlarından önce gelir. Tüm analizlerde ortamın düşme sonlandırması devre dışı bırakılmış ve aynı ölçüt, otomatik sıfırlama olmayıp düşme anındaki durumun kaydedilebilmesi için analiz kodunda her kontrol adımında uygulanmıştır; sonlandırma koşulu yalnızca sıfırlamayı tetiklemek için kullanıldığından düşmeden önceki dinamikleri değiştirmez. Değerlendirme ortami, görevin ayak sürtünmesi (0,3–1,2), eklem kodlayıcı kayması (±0,015 rad) ve gövde kütle merkezi ofseti (yatayda ±2,5 cm, dikeyde ±3 cm) başlangıç rastlantısalını korur. Tek tek yürütme deneylerinde bu nicelikler ve başlangıç konumu ortam tohumu (100) ile sabitlenir ve politika deterministik (ortalama) aksiyonuyla değerlendirilir.
İşlemci hızlandırmalı simülatör, çalışmalara bitwise düzeyinde deterministik değildir. Bu nedenle, aynı koşulun tekrarlanan değerlendirmelerinin, tam eşik üzerinde yer alan denemeler için (Bölüm 3.2) her zaman aynı sonuçları verdiği garantili değildir. Bu nedenle tek tek yürütme düşme oranları, tek bir sabit koşulda politika-politika değişkenliğini yansıtır ve nicelsel temel sonuçlar tekrarlanan denemeler analizinə (Bölüm 2.5) dayanır.
2.4 Tanımlar ve eşik tahmini
Aşağıdaki terimler tüm metin boyunca kullanılır.
-
Kalan motor çıktısı (α): 13 hedef eklemin çıkış katmanı ağırlıkları ve önyapıları üzerinde uygulanan çarpan (α = 1, değiştirilmemiş; α = 0, tamamen yok edilmiş).
-
Zayıflatma: 1 − α (örneğin, α = 0.65, %35 zayıflatmaya karşılık gelir).
-
Düşme: 250 kontrol adımında (5 s) dikeye göre 70°’yi aşan kalça açısı.
-
Politika başına eşik (tek çalıştırma): bir politikanın düşmediği en düşük test edilen α değeri (5’lik yüzde puanı gridi).
-
Grup düzeyinde eşik: sekiz politikanın düşme oranının ≥ %50 olduğu en yüksek test edilen α değeri.
-
Politika başına %50 eşik (tekrarlı denemeler): bir politikanın 10 koşul düşme olasılığının %50’yi geçtiği α değeri (lineer enterpolasyon).
Eşikler, 0.5 m/s ileri hızda üç aşamada tahmin edildi. Tam aralık üzerinde (α = 1.0, 0.8, 0.6, 0.4, 0.2, 0.0; sekiz politika) yapılan kaba tarama geçişi yerelleştirdi. Bunu saran aralıkta (α = 0.6–0.8) ikili bölme araması yalnızca ince taramanın aralığını seçmek için kullanıldı (α = 0.55–0.75, 0.05 basamaklarla; sekiz politika) ve 0.55’e kadar genişletildi, çünkü sol taraf zayıflatması kaba taramada α = 0.6’da henüz %100 bir düşme oranına ulaşmamıştı; buradan politika başına ve grup düzeyindeki eşikler hesaplandı.
2.5 Tekrarlı denemeler ve değişkenlik kaynakları
Politika ile politika arasındaki değişkenliği politika içi değişkenlikten ayırmak için her politika, beş ince tarama seviyesinin her birinde ve her iki yüzde için de 10 rastgele koşul altında değerlendirildi (8 politika × 2 yüzde × 5 seviye × 10 koşul = 800 deneme, 0,5 m/s). Koşullar başlangıç pozisyonu (x ve y’de ±0,5 m), başlangıç düşme yüksekliği (0,01–0,05 m) ve Bölüm 2.3’te listelenen başlatma rastgeleştirmesi açısından farklıydı. Ortam tohumu ile sabitlenen aynı 10 koşul, tüm politikalar, yüzdeler ve seviyeler için kullanıldı. Her yüzde ve seviye için ikili düşme sonucunun varyansı, politikalar arası bileşen (politika başına düşme olasılıklarının varianceansı) ve politika içi bileşen (ortalama binom varyansı) olmak üzere ikiye ayrıldı. Politika başına %50 eşik değerleri ve bunların sağ–sol farkları, politikalar üzerinden ortalamaları ve %95 bootstrap güven aralıkları ile özetlendi (10.000 yeniden örnekleme).
2.6 Hız bağımlılığı ve istatistiksel analiz
Ince tarama, 0,3, 0,5, 0,7 ve 0,9 m/s komutlu ileri hızlarda tekrarlandı (tek serili yürütme). Sağ–sol karşılaştırmaları her politika içinde yapıldı. Tek serili yürütme verileri için iki yüzdenin politika başına eşik değerleri, eşitlikler hariç tutularak kesin iki yönlü işaret testi ile karşılaştırıldı. Tekrarlanan deneme verileri için politika başına %50 eşik değerleri, işaret testi eş zamanlı olarak raporlanarak kesin iki yönlü Wilcoxon eşlenmiş işaretli rank testi ile karşılaştırıldı. 0,5 m/s hızı, tüm eşik tahmini aşamaları ve tekrarlanan denemeler için birincil koşuldur; diğer hızlar ikincil analizlerdir ve hızlar arasında çoklu karşılaştırma düzeltmesi uygulanmamıştır. Sekiz politika ve yüzde başına 5’lik bir ızgara ile tüm tahminlerin hassaslığı sınırlıdır ve sonuçlar bu durum göz önünde bulundurularak raporlanmıştır.
2.7 Düşme başlangıcından önce ve anındaki eklem konfigürasyonu
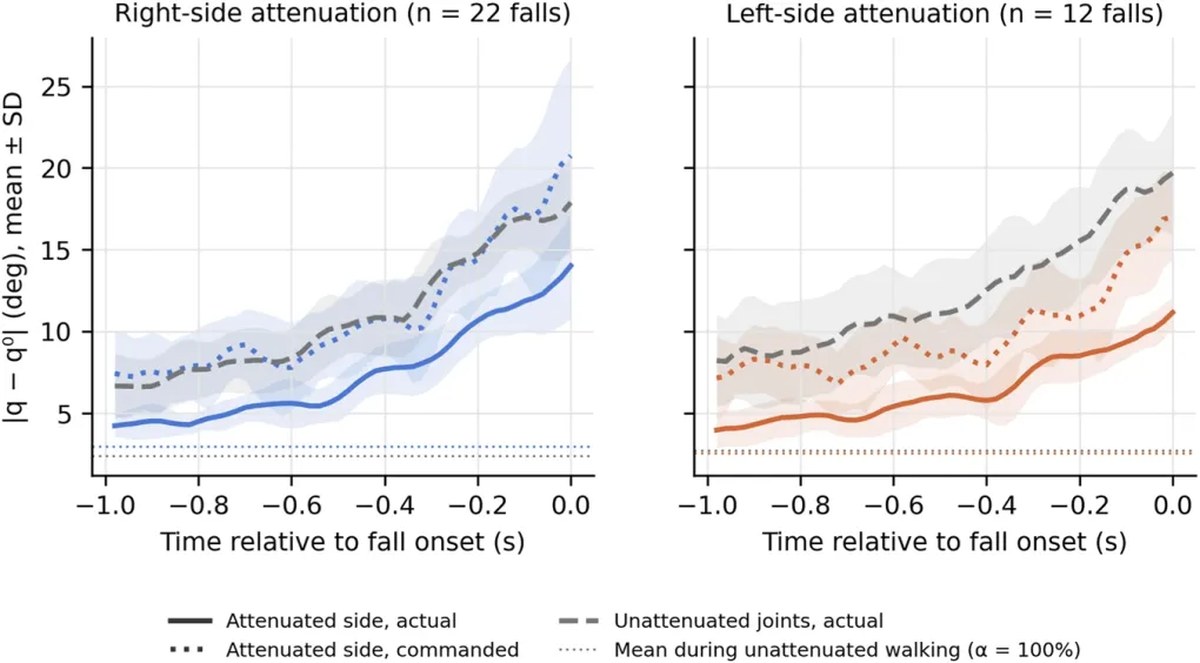
İnce tarama sırasındaki her düşme denemesi için 0.5 m/s hızda (ve attenuasyon uygulanmayan temel durum) ekleme açıları q ve komutlanan hedefler q∗, düşme başlangıcına kadar her kontrol adımında kaydedildi; aynı koşullar altında ayrı bir çalıştırma gerçekleştirildi (Tablo 1’deki 34 denemenin tamamı düştü; düşme başlangıcı en fazla 5 kontrol adımında farklıydı). Her deneme için varsayılan duruştan ortalama mutlak sapma, |q − q0| ve |q∗ − q0|, düşme başlangıcında ve öncesindeki 0.5 s boyunca ortalaması alınarak ayrı ayrı 13 attenuasyon uygulanan eklem ve 16 attenuasyon uygulanmayan eklem için hesaplandı; ayrıca temel durumda düzenli yürüyüş sırasında (kontrol adımları 50–250) hesaplandı. Varsayılan duruş q0, mjlab dizleri bükük anahtar kareidir (kalça açısı −0.312 rad, diz 0.669 rad, ayak bileği açısı −0.363 rad, dirsek 0.6 rad, omuz açısı 0.2 rad, omuz dönmesi ±0.2 rad; diğer tüm eklemler 0); aynı zamanda sıfır eyleminin eşlendiği ve bir bölümün sıfırlandığı duruştur (Ek Tablo S3). Düşme başlangıcından önceki son 1 s’lik zaman eğrisi Şekil 1’de gösterilmektedir.
TABLE 1
| Kalan çıkış α | Sol taraf attenuasyonu | Sağ taraf attenuasyonu |
|---|---|---|
| 75% | 0% | 0% |
| 70% | 0% | 12.5% |
| 65% | 12.5% | 62.5% |
| 60% | 37.5% | 100% |
| 55% | 100% | 100% |
İnce tarama: kalan motor çıkışına göre düşme oranı (0.5 m/s, 8 politika, tek çalıştırma).
FIGURE 1
2.8 Attenuasyon olmadan ve ölçülen yürüyüş hızı için sol–sağ karşılaştırması
Sol–sağ farkının zayıflatma olmadan zaten mevcut olup olmadığını test etmek için her politika, Bölüm 2.5’in 10 rastgele koşulu altında zayıflatma olmadan (α = 1) çalıştırıldı ve 2.3’teki gibi düşme sonlandırma devre dışı bırakıldı. Sabit yürüme aralığı (kontrol adımları 50–250) boyunca, her iki tarafın 13 eklemi ve her iki tarafın 6 bacak eklemi için ayrı ayrı, varsayılan duruştan ortalama komutlanan sapma |q∗ − q0|, izleme hatası |q∗ − q|, aktüatör momenti |τ| (mutlak ve moment sınırıyla karşılaştırıldığında) ve mekanik güç |τ q̇| hesaplandı. Aktüatör momentleri, her aktüatör eklemine eşlendikten sonra simülatörün aktüatör kuvvetlerinden okundu; Bölüm 2.2’deki PD kontrol yasasıyla uyumluydular (her çalışmada korelasyon > 0.998). Her ölçüm için, politika başına bir asimetri endeksi 100 × (R − L) / ((R + L)/2) hesaplandı, iki taraf sekiz politika üzerinden tam Wilcoxon eşleşmemiş çiftler için işaretli rank testiyle karşılaştırıldı ve politika başına 0.5 m/s’deki asimetri endeksi, politika başına eşik farklarıyla (tek rollout ve tekrarlı denemeler) Spearman korelasyonuyla ilişkilendirildi. Bu analizler keşif amaçlıydı ve çoklu karşılaştırmalar için düzeltme uygulanmadı. Ölçülen yürüme hızı, aynı aralıkta pelvisin kendi çerçevesindeki ortalama ileri hızıydı.
3 Bulgular
3.1 Kaba tarama, 60% ve 80% kalan çıkış arasındaki geçişi yerleştirir
Kaba taramada (Tablo 2), sekiz politikanın her iki tarafta da 100% ve 80% kalan çıkışta düşmeden yürüdüğü, 40% ya da daha azında ise hepsinin düştüğü görüldü. 60%’de sağ taraf zayıflatması sekiz politikanın hepsinin düşmesine, sol taraf zayıflatması ise sekizden dördünün düşmesine yol açtı.
TABLE 2
| Kalan çıktı α | Sol taraf zayıflatması | Sağ taraf zayıflatması |
|---|---|---|
| 100% | 0% | 0% |
| 80% | 0% | 0% |
| 60% | 50% | 100% |
| 40% | 100% | 100% |
| 20% | 100% | 100% |
| 0% | 100% | 100% |
Kaba tarama: kalan motor çıktısına göre düşme oranı (0,5 m/s, 8 politika, tek seferlik çalıştırma).
3.2 İnce tarama ve politika başına eşikler
İnce tarama (Tablo 1), 55% ile 75% arasındaki çıkış dönüşümünü belirledi. Politika başına eşikler, sağ taraf zayıflatması için %65 ile %75 arasında (ortalama %68,75) ve sol taraf zayıflatması için %60 ile %70 arasında (ortalama %62,5) değişiyordu. Sekiz politikanın her birinin eşiti, hem tek seferlik taramadan hem de tekrarlanan denemelerden (Bölüm 3.3), Ek Tablo S2’de listelenmiştir. α = 0,60’daki sol taraf zayıflatması, ince taramada 8 düşmeden 3’ünü ancak kaba taramada 8 düşmeden 4’ünü üretti (Tablo 2), koşullar özdeştir. Bu durum, GPU simülatörünün deneme-deneme belirsizliğini (Bölüm 2.3) yansıtır: tam olarak eşik üzerinde yer alan bir deneme, değerlendirmeler arasında sonucu değiştirebilir.
3.3 Tekrarlanan denemeler: eşikler ve politika içi değişkenlik
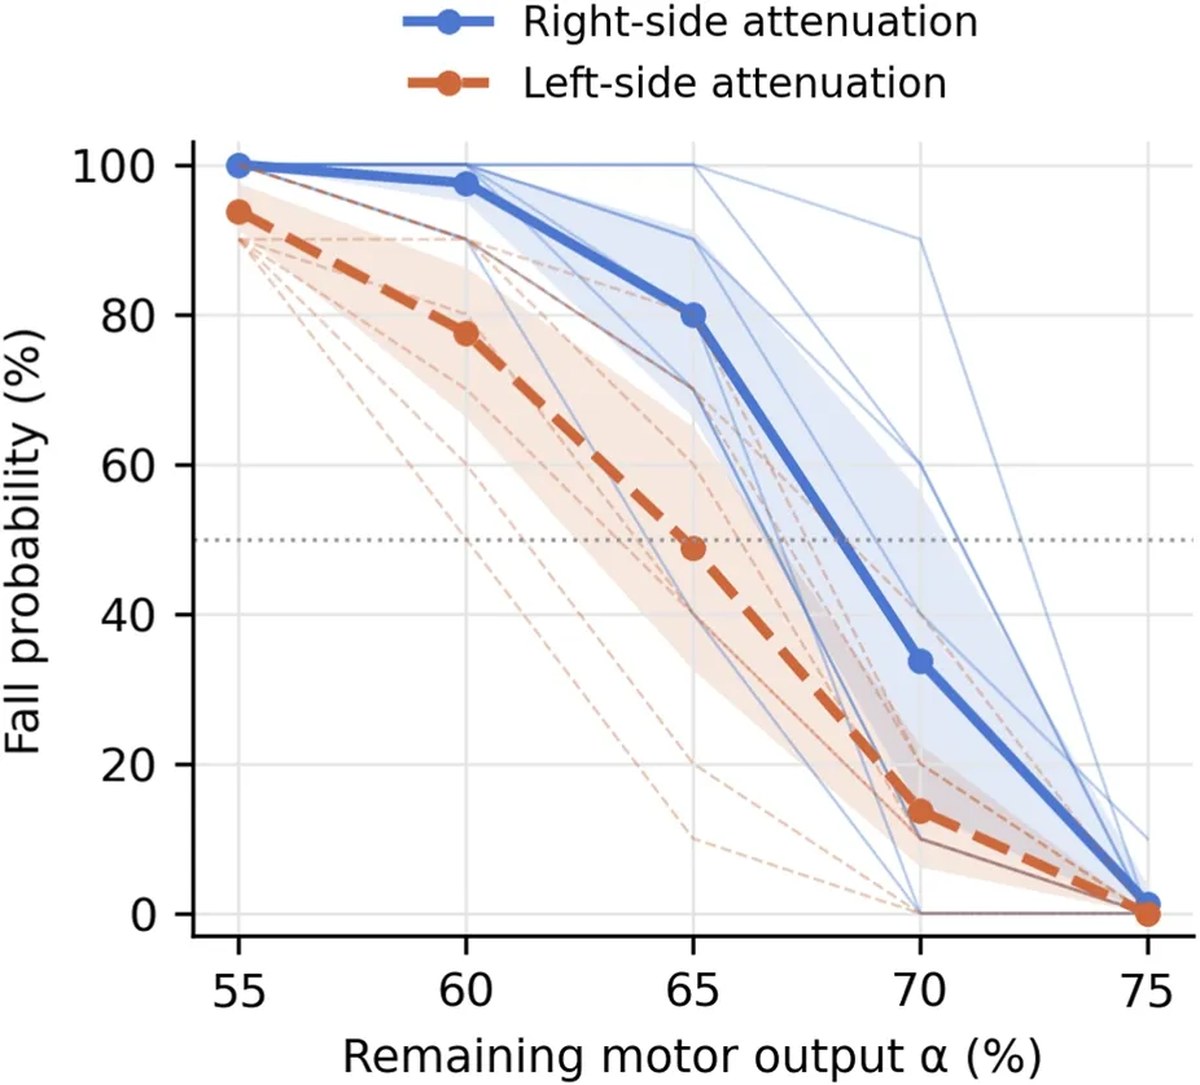
Politika başına 10 rastgele koşul altında, düşme olasılığı her politika için artan α ile monoton olarak azaldı (Şekil 2). Politika içi değişkenlik belirgindi: her iki tarafın eşiklerine yakın bireysel politikalar, koşulların %10–80’i (sol taraf, α = 0,65) ve %0–90’ı (sağ taraf, α = 0,70) içinde düştü. Politikalar arası farklar, zayıflatma seviyeleri düşme sonucundaki varyansın %4–45’ini açıkladı (her iki tarafın eşiklerine en yakın seviyelerde %22–45), geri kalanı ise politikalar içinde ortaya çıktı. Politika başına 50% eşiti, sağ taraf zayıflatması için %68,4 (95% bootstrap güven aralığı %66,6–%70,1) ve sol taraf zayıflatması için %64,6 (%62,6–%66,6) olarak bulundu (politika başına değerler Ek Tablo S2’de).
ŞEKİL 2
3.4 Sol–sağ karşılaştırması
Tek tek denemeli ince taramada, sağ tarafın zayıflatılması 8 politikanın 6’sında daha yüksek politika başına eşik değerine sahipti; ters yönde olan yokken 2’si berabereydi (kesin işaret testi, p = 0,031). Tekrarlı deneme verilerinde sağ tarafın %50’lik eşik değeri 8 politikanın 7’sinde daha yüksekti (Wilcoxon işaretli sıralama testi, p = 0,039; işaret testi, p = 0,070) ve bir politika (seed 3) tersini gösterdi. Ortalamalar arasındaki fark 3,7 puan oldu (95% bootstrap güven aralığı 1,2–6,0).
Zayıflatma olmadan politikalar zaten küçük, sağ baskın bir asimetri gösteriyordu (Ek Tablo S5). Her ölçüm için her komutlanan hızda ortalı asimetri endeksi sağ tarafı destekledi; her iki tarafın 13 eklemini içeren her ölçümde komutlanan sapma için %4,0–7,7, izleme hatası için %4,4–5,7, tork için %4,9–5,4 ve mekanik güç için %7,7–12,1 oldu ve sağ taraf 8 politikanın 5–7’sinde sol tarafı geçti. Bireysel olarak bu farklar yalnızca 40 yan-ölçüm-hız özgü karşılaştırmadan 4’ünde p < 0,05 değerine ulaştı (düzeltilmemiş). Politika başına asimetri endeksleri, politika başına eşik farklarıyla tutarlı biçimde ilişkili değildi: 20 karşılaştırmadan 19’unda |ρ| ≤ 0,64 ve p ≥ 0,086 ve p < 0,05 değerine ulaşan tek korelasyon (ρ = −0,76, tekrarlı deneme farkına karşı leg torku) açıklayıcı bir ilişkinin tersi yöndeydi. Hiçbir politika zayıflatma olmadan düşmedi (320 denemenin 0’ı).
3.5 Hıza bağlılık
Dört hızın tamamında sağ tarafın zayıflatılması için grup düzeyindeki eşik, sol tarafın zayıflatılması için olan eşiğin altına düşmemiştir (Tablo 3; Şekil 3; koşula göre düşme oranları Ek Tablo S1): iki taraf 0,3 m/s’de 0,3 m/s (60%) ile eşittiyken, sağ taraf 0,5 m/s’de (65% ile 55% arasında) daha yüksektir, 0,7 m/s ve 0,9 m/s’de ise 65% ile 60% arasında daha yüksektir. Bireysel politika düzeyinde, her hızda sağ tarafın eşiği 8 politikanın 5-6’sında daha yüksektir, en fazla bir tersilme olmakla birlikte, işaret testi yalnızca 0,5 m/s’de anlamlıdır. Sol–sağ farkı hızla monotonik olarak değişmemiştir. Politika başına ortalamaya dayalı eşikler her iki tarafta hızla hafifçe artmıştır (0,3 ile 0,9 m/s arasında sağ tarafın zayıflatılması için 66,9%’dan 70,6%’ya ve sol tarafın zayıflatılması için 62,5%’den 64,4%’a), ancak bu farklar 5 yüzde puanlık ızgaranın çözünürlüğü içinde kalmaktadır. Bir politika (seed 8, 0,7 m/s’de sağ tarafın zayıflatılması) α = 0,75’te düşmüş ancak α = 0,70’de düşmemiştir; Bölüm 2.4’teki tanıma göre bu politikanın eşiği 70% olarak alınmıştır. Diğer tüm politika başına diziler monotoniktir. Bu nedenle asimetri, grup düzeyinde yönde tutarlı ancak istatistiksel olarak yalnızca 0,5 m/s’de desteklenmektedir.
TABLE 3
| Hız | Grup düzeyi eşik, sol / sağ | Politika başına ortalamaya dayalı eşik, sol / sağ | Sağ > sol / sol > sağ / eşitlikler | İşket testi p |
|---|---|---|---|---|
| 0,3 m/s | 60% / 60% | 62,5% / 66,9% | 5 / 1 / 2 | 0,22 |
| 0,5 m/s | 55% / 65% | 62,5% / 68,75% | 6 / 0 / 2 | 0,031 |
| 0,7 m/s | 60% / 65% | 63,75% / 69,4% | 6 / 1 / 1 | 0,125 |
| 0,9 m/s | 60% / 65% | 64,4% / 70,6% | 6 / 1 / 1 | 0,125 |
Hıza bağlılık (tek rollout, 8 politika). Grup düzeyi eşik, politika başına ortalamaya dayalı eşik ve politika başına sol–sağ karşılaştırması.
FIGURE 3
Hızlar komut verilen hızlardır. Zayıflatılmayan politikalının ölçülen kararlı durum yürüme hızı daha düşüktü: komut verilen 0.3, 0.5, 0.7 ve 0.9 m/s hızlarında ortalamaya göre sırasıyla 0.225, 0.432, 0.619 ve 0.803 m/s (politikalar arasında aralıklar 0.196–0.246, 0.406–0.448, 0.601–0.637 ve 0.783–0.826 m/s; Ek Tablo S5).
3.6 Düşme öncesi ve düşme anında eklem konfigürasyonu
İnce taramanın 34 denemesi düştü (22’si sağ taraf, 12’si sol taraf zayıflatması ile). Zayıflatılmaya yürürken, gerçek eklem açılarının varsayılan duruştan ortalama sapması 2.4–3.0° idi. Düşmeden önce eklemler son ≈0.6 s içinde varsayılan duruştan giderek uzaklaştı (Şekil 1). Düşme anında ortalama sapma zayıflatılan eklemlerde 10.7–21.1°, zayıflatılmayan eklemlerde 16.8–26.5° idi (yanlar ve zayıflatma düzeyleri boyunca grup ortalamalarının aralıkları); herhangi bir düşmede zayıflatılan eklemlerin en küçük sapması 7.1° idi. Komut verilen hedefler aynı şekilde uzaklaştı (zayıflatılan eklemlerde düşme anında 15.8–38.0°, zayıflatılmaya yürürken 7.2–7.9°). Her bir grup ortalamasında ve 34 bireysel düşmenin 31’inde sapmalar zayıflatılmayan eklemlerde zayıflatılan eklemlerden daha büyüktü.
4 Tartışma
4.1 Tek taraflı komut bozulması için ölçülebilir bir marj
Eğitilmiş bir önden-iletim (feedforward) insan formunda lokomosi politikasının, yeniden eğitim yapmadan tek taraflı motor komutlarının yaklaşık %25–40’ının çıkarılmasını tolere ettiği ve buna karşılık dar bir azaltım bandında başarısız olduğu görüldü. α komut genliğini ölçeklendirdiği ve tork kapasitesi ile ek sertliğini koruduğu için (Bölüm 2.2), bu eşik politikanın istenen hareket kaybına karşı denge-kontrol marjını tanımlar ve bu da öğrenilen denetleyicilerde tek taraflı komut veya sürücü bozulması açısından önem taşır. Tekrarlanan denemeler analizi, tek bir çalıştırmanın (rollout) bu marjı ancak yaklaşık olarak yakaladığını gösteriyor: Eşiğe yakın bölgede, belirli bir politikanın düşüp düşmemesi büyük ölçüde başlangıç koşulları ve fiziksel parametrelerdeki küçük farklara, hatta simülatördeki çalıştırma-çalıştırma sayısal farklarına bağlıdır. Bu nedenle, öğrenilen politikalar için eşik tahminlerinin tekrarlanan denemeler üzerine kurulmasının önerildiğini belirtiyoruz.
Bu sonuçların gerçek aktüatör arızalarıyla nasıl ilişkilendiği, arızanın türüne bağlıdır. Donanım üzerinde eklemsel arızalar genellikle kullanılabilir torkun kaybı veya düşürülmesi (arızalı veya aşırı ısınan motor sürücüsü), aktarma organındaki artan sürtünme veya boşluk, kodlayıcı (encoder) hataları ya da gecikmeli ve kaybedilen komutlar biçiminde ortaya çıkar. Bizim uyguladığımız azaltım farklı bir noktada işler: aksi halde sağlıklı olan aktüatörlere gönderilen konum komutunu küçültür; bu aktüatörlerin tork sınırları ve PD sertliği değişmez (Bölüm 2.2). Bu nedenle burada bildirilen eşikler, doğrudan komut düzeyindeki bozulmaya—örneğin düşürülmüş bir komut kazancı veya kısmen bozulmuş bir çıkış kanalı—yöneliktir ve motor torkunun tolere edilebilir kaybı olarak okunamaz. Aynı zamanda yaygın simülatörden-gerçekliğe geçiş (sim-to-real) açığına tabidir, çünkü aktüatör dinamiği, gecikme, sensör gürültüsü ve temas ancak yaklaşık olarak modellenmiştir (Peng ve ark., 2018). Bu marjların pratik arıza toleransı için kullanılabilmesi için aynı protokollerin donanım üzerinde ya da simüle edilmiş tork-sınırı ve gecikme arızalarıyla test edilmesi gerekir.
4.2 Mütevazı, yön tutarlı bir sol–sağ asimetri
Sağ taraf çoğu politika için ortalama yaklaşık 4 yüzde puanı daha kırılgandı ve bir politikada bu durum tersine dönmüştü. Robot modeli nominal olarak simetrik ve rastgele fiziksel parametreler dağılım bakımından simetrik olduğundan, bu asimetri büyük olasılıkla eğitilen politikalardan kaynaklanıyor; 8 politikanın 7’sinde 10 rastgele koşulda tutarlı olarak sürmesi, asimetrinin tek bir asimetrik başlangıç koşulundan kaynaklandığı iddiasına karşı çıkıyor. Eşlik eden tek eklemli ablasyon çalışması da sağ taraf kritik eklemeleri bildirmiştir (Obaru, 2026a); ancak mevcut sonuç yalnızca burada bildirilen verilere dayanıyor ve çalışmalar arasında genel bir mekanizma iddia edilmiyor. İki çalışma farklı soruları soruyor: tek eklemli ablasyon, çıktı tamamen kaldırıldığında hangi bireysel eklemelerin kritik olduğunu belirlerken, mevcut çalışma bir taraftaki tüm eklemelerin eşzamanlı ve kademeli zayıflatmasının politikanın ne kadarını tolere ettiğini ve bunun politika, başlangıç koşulları ve yürüyüş hızları arasındaki değişkenliğini nicelendiriyor. Tam ablasyon altındaki bireysel eklemelerin kritikliği, bu eşiği tek başına belirlemiyor. Sekiz politika ve yalnızca 0,5 m/s’de politika başına anlamlı bir sonuç verilmesi nedeniyle, asimetrinin mütevazı sayılması ve daha büyük politika gruplarıyla doğrulamaya ihtiyaç duyması gerekiyor.
Zayıflatılmamış politikalar sağ tarafı sol tarafından biraz daha fazla komut veriyor ve yüklüyordu (Bölüm 3.4). Bu başlangıç asimetrisi bağımsız eğitilen politikaların çoğu tarafından paylaşıldığından, sistematik bir öğrenilmiş politika özelliğidir ve tek bir seed’in (tohum) bir yan ürünü değildir; ayrıca eşik asimetrisinin yönüyle tutarlıdır: zayıflatma, biraz daha büyük bir komutun sabit bir oranını kaldırır. Ancak büyüklüğü, hangi politikaların daha büyük eşik farkı gösterdiğini öngöremediğinden, asimetriyi tek başına açıklayamıyor.
4.3 Düşmeler, varsayılan duruşa yakınsamadan önce ıraksamayla eşleştirilir
Otomatik olarak sonlanan epizodları adım fonksiyonu içinde sıfırlayan ortamlarda, mjlab buna bir örnektir, sıfırlama adımında döndürülen durum, düşme anının değil sıfırlama varsayılan duruşunun durumudur; bu değeri basitçe okumak varsayılan duruşa tam yakınsama izlenimi verir. Bu nedenle sıfırlamadan önceki durumu ölçtük (Bölüm 2.3). Durum düşme başlangıcında böyle ölçüldüğünde karşıt bir örüntü ortaya çıkar: Bir düşmeden önceki son ≈0,6 s içinde hem komutlanan hedefler hem de gerçek eklem açıları varsayılan duruşundan giderek uzaklaşır, zayıflatılmayan eklemelerde bu uzaklaşma daha belirgindir. Bu, pasif bir çökme değil, dengeyi geri kazandıramayan büyük bütün-vücut düzeltici hareketleri olduğunu gösterir. Burada elde edilen düşme başlangıcındaki bütün-vücut durumu, ilk koşul olarak düşme dinamiği ve çarpışma çalışmalarına hizmet edebilir; bunlar düşmenin kendisinin kinematiğini karakterize eder (Ferrari ve ark., 2026). Ancak G1, insan dışı bir vücut planına sahip, torkla tahrik edilen 33 kg’lık bir robotur ve düşme başlangıcı durumları insan yaralanma riskini doğrudan tahmin etmek için kullanılamaz.
4.4 Hemiparezis ve muskuloskelet simülasyonuyla ilişki
Atenuasyon tasarımı, akut hemipareziden kaynaklansa da, mevcut bulgular inme modeli olarak yorumlanmamalıdır. Kas-iskelet simülasyon çalışmalarında kas gücü kapasitesi azaltılır, ardından kontrolcü yeniden optimize edilir veya eğitilir (Ong et al., 2019; Falisse et al., 2020; Choi et al., 2026); oysa bizim yaptığımız manipülasyon, uyumlanmamış bir politikanın komut genliğini ölçeklendirir. Inme sonrası düşmeler, inme sonrası tüm evrelerde sık görülür ve denge ile yürüme bozuklukları başlıca risk faktörüdür (Weerdesteyn et al., 2008). Geriatrik inme rehabilitasyonunda ileri sürülen bir kohort çalışmalarında hastaların %36’sı ilk 8 hafta içinde düşmüş; düşme riski, ciddi postür bozukluğu, bilateral motor bozukluk, visuospatial hemineglekt, günlük yaşam aktivitelerinde bağımlılık, idrar kaçırma ve ilaç kullanımıyla ilişkiliyken, genel motor fonksiyon puanı veya bilateral lezyonlar dışındaki lezyon yerleşimiyle ilişkili değildi (Nyberg and Gustafson, 1997). İnsanlarda inme sonrası düşme riski dolayısıyla birbiriyle etkileşen birçok faktöre yansırken, bizim manipülasyonumuz tek bir faktörü izole eder. Burada bildirilen eşik, politikanın denge-kontrol marjına ait bir özelliktir ve klinik şiddet eşiği değildir; sol-sağ asimetri büyük olasılıkla politikanın öğrendiği bir asimetriyi yansıtır ve insanlarda inme sonrası lezyon tarafına bağlı etkilerle karşılaştırılmamalıdır; burada lateraliteye bağlı düşme riski, hemineglekt gibi algısal ve bilişsel faktörlerle ilişkilendirilmiştir (Nyberg and Gustafson, 1997).
5 Sınırlılıklar
-
Sadece simülasyon. Tüm sonuçlar simülasyon ortamında elde edilmiş olup donanım üzerinde doğrulanmamıştır. Aktuatör dinamiği, sensör gürültüsü, temas modellemesi ve simülasyon ile gerçek robot arasındaki gecikme farkları eşiklerin yerini değiştirebilir.
-
Tek platform ve politika ailesi. Tüm bulgular yalnızca Unitree G1 modeli ve burada kullanılan mjlab eğitili öngerisim politikalara özgedir.
-
Pertürbasyonun anlamı. Zayıflatma, komut genliğini varsayılan duruşa doğru ölçeklendirir ve tork kapasitesini azaltmaz; bu, kas zayıflığının veya insan hemiparezinin bir modeli değildir.
-
Örneklem boyutu ve çözünürlük. Sekiz politika ve yüzde beşlik ızgara, eşiklerin kesinliğini ve sağ-sol karşılaştırmalarının gücünü sınırlar; politika başına asimetri yalnızca 0,5 m/s hızında anlamlıydı ve hız bağımlılığı yalnızca tek seferlik çalıştırmalarla değerlendirilmiştir.
-
Değişkenlik ve belirlenmişlik. Politika içi değişkenlik belirgin olup GPU simülatörü çalıştırma arasında bit-bit belirlenmiş değildir, bu nedenle eşeğe yakın düşme oranları tekrarlı değerlendirmeler arasında farklılık gösterebilir. Değerlendirme, eğitim sırasında uygulanan gözlem gürültüsü olmadan gerçekleştirilmiştir, bu nedenle sensör gürültüsünün varlığında eşikler daha düşük olabilir.
-
Motor yeniden öğrenme yok. Akut, eğitimsiz tasarım; eşikin veya asimetrinin, politikanın kalıcı bir eksikliğe uyum sağlamasına izin verilseydi nasıl değişeceği sorusunu yanıtlayamaz.
-
Anatomi açısından kaba pertürbasyon. Tüm bir tarafın düzgün zayıflatması, kısmi veya ekleme özgü zayıflık örüntülerini yakalamaz.
6 Gelecekteki çalışmalar
-
Eşitleme eşiğinin tüm hızlarda ve daha büyük politika gruplarıyla tekrar tekrar tahmini, sol–sağ asimetrinin sağlam olup olmadığını test etmek için.
-
Kısmi zayıflama (yalnızca bacak, yalnızca kol veya eklem özgül), bir tarafın marjı hangi bileşenlerin taşıdığını belirlemek için.
-
Zayıflama yerinde yeniden eğitim, kalıcı bir eksikliğe uyumlanmayı modellemek için.
-
Bileşik çalışmanın tek eklemli yok etme sonuçlarıyla bireysel politika düzeyinde nicel karşılaştırma.
-
Kas sürücülü iskelet-kas modelleri (ör. MyoSuite; Caggiano ve ark., 2022), zayıflamanın belirli kasların azalmış maksimum izometrik gücü olarak tanımlanabildiği, böyle modellere için güvenilir ve tekrarlanabilir yürüme politikaları sağlandığında.
-
Düşme başlangıç durumlarının, insan iskelet-kas veya dijital-insan modellerinde düşme dinamiği ve çarpışma simülasyonları için başlangıç koşulları olarak kullanımı; bu, insan yaralanma riski hakkında herhangi bir çıkarım yapılmadan önce gerekli olacaktır.
Açıklamalar
Veri erişilebilirliği açıklaması
Bu çalışmada sunulan veri setleri çevrimiçi veri havuzlarında bulunabilir: https://github.com/rehabiliworld1-max/fall-threshold-unilateral-attenuation (analiz defterleri, tüm taramalar için deneme bazlı sonuç tabloları ve sekiz tohumun tümü için eğitilmiş politika noktaları).
Yazar katkıları
KO: Kavramsal çerçeve, Doğrulama, İnceleme ve düzenleme (yazım), Resmi analiz, Yönetim, Yöntem, Veri düzenleme, Yazılım, Soruşturma, Kaynaklar, Görselleştirme, Orijinal metin (yazım), Proje yönetimi.
Finansman
Yazar(lar), bu çalışma ve/veya yayını için finansal destek alınmadığını beyan etmiştir.
Çıkar çatışması
Yazar(lar), bu çalışmanın ticari veya olası bir çıkar çatışması olarak değerlendirilebilecek herhangi bir finansal ilişki olmadan yürütüldüğünü beyan etmiştir.
Üretken yapay zekâ açıklaması
Yazar(lar), bu metnin oluşturulmasında üretken yapay zekânın kullanıldığını bildirmiştir. Üretken yapay zekâ (Claude, Anthropic); metnin taslak ve düzenleme aşamalarında destek sağlamak, literatür atıflarını doğrulamak, metni ve ek malzemeleri dergi kurallarına uygun biçimde biçimlendirmek ve bu çalışmanın hazırlık sürecinde analiz kodlarındaki sorunları çözmek amacıyla kullanılmıştır. Tüm deney tasarımı, simülasyon yürütülmesi, veri analizi ve bilimsel sonuçlar yalnızca yazarın kendisine aittir. Yazar, bu metindeki tüm içeriği gözden geçirmiş, doğrulamış ve tüm içeriğin tam sorumluluğunu üstlenmiştir.
Bu makaledeki şekillerle birlikte sunulan alternatif metinler (alt text) Frontiers tarafından yapay zekânın desteğiyle üretilmiştir; olabildiğince yazarların gözden geçirmesini de içeren makul çabalar doğruluklarının sağlanması için alınmıştır. Herhangi bir sorunu tespit ederseniz, lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, ayrıca yayıncının, editörlerin ve hakemlerin görüşlerini her zaman yansıtmaz. Bu makalede değerlendirilebilecek herhangi bir ürün ya da üreticisinin yapabileceği herhangi bir iddie yayıncı tarafından garanti edilmez veya desteklenmez.
Ek malzeme
Bu makalenin Ek Malzemesi çevrimiçi olarak şu adreste bulunabilir: https://www.frontiersin.org/articles/10.3389/frobt.2026.1959239/full#supplementary-material
-
Caggiano V, Wang H, Durandau G, Sartori M, Kumar V. (2022). MyoSuite: a contact-rich simulation suite for musculoskeletal motor control. Proc. 4th Annu. Learn. Dyn. Control Conf. 168, 492–507. 10.48550/arXiv.2205.13600
- CrossRef
- Google Scholar
- View reference in article
-
Choi I, Park I, Halilaj E, Kang I. (2026). Musculoskeletal Motion Imitation for Learning Personalized Exoskeleton Control Policy in Impaired Gait, arXiv:2604. 09431. 10.48550/arXiv.2604.09431
- CrossRef
- Google Scholar
- View reference in article
-
Cully A., Clune J., Tarapore D., Mouret J.-B. (2015). Hayvanlar gibi uyum sağlayabilen robotlar. Nature521, 503–507. 10.1038/nature14422
- Pubmed Abstract
- CrossRef
- Google Scholar
- Kaynağa bak
-
Falisse A., Serrancolí G., Galle S., Sartori M., Jonkers I., De Groote F. (2020). Beyin felcinde yürüme bozukluğuna motor kontrol ve kas-iskelet defisitlerinin ayrı ayrı etkilerini öngören fizik temelli simülasyonlar: geriye dönük olgu çalışması. Front. Hum. Neurosci.14, 40. 10.3389/fnhum.2020.00040
- CrossRef
- Google Scholar
- Kaynağa bak
-
Ferrari D., Regazzoni D., Rizzi C., Vitali A. (2026). İnsan düşmelerinin 3B kinematiği: OpenCap ve SAM3D bedeninin eylemsiz hareket yakalama ile değerlendirilmesi. Int. J. Interact. Des. Manuf.10.1007/s12008-026-02653-y
- CrossRef
- Google Scholar
- Kaynağa bak
-
Hwangbo J., Lee J., Dosovitskiy A., Bellicoso D., Tsounis V., Koltun V. ve ark. (2019). Ayaklı robotlar için çevik ve dinamik motor becerilerin öğrenilmesi. Sci. Robot.4, eaau5872. 10.1126/scirobotics.aau5872
- Pubmed Abstract
- CrossRef
- Google Scholar
- Kaynağa bak
-
Lee J., Hwangbo J., Wellhausen L., Koltun V., Hutter M. (2020). Zor arazide dörtlü ayaklı hareketin öğrenilmesi. Sci. Robot.5, eabc5986. 10.1126/scirobotics.abc5986
- Pubmed Abstract
- CrossRef
- Google Scholar
- Kaynağa bak
-
Mirza K. Z., Singh S. (2025). Ayaklı robot hareketi için taklit öğrenmesi: bir derleme. Front. Robot. AI12, 1678567. 10.3389/frobt.2025.1678567
- Pubmed Abstract
- CrossRef
- Google Scholar
- Kaynağa bak
-
Morcos A. S. Barrett D. G. T. Rabinowitz N. C. Botvinick M. (2018). “Genelleşme için tek yönlere verilen önem,” International Conference on Learning Representations (ICLR) içinde. 10.48550/arXiv.1803.06959
- CrossRef
- Google Scholar
- Makalede kaynağı görüntüle
-
Nyberg L. Gustafson Y. (1997). İnme rehabilitasyonundaki hastalar için düşme tahmin indeksi. Stroke 28, 716–721. 10.1161/01.STR.28.4.716
- Pubmed Özeti
- CrossRef
- Google Scholar
- Makalede kaynağı görüntüle
-
Obaru K. (2026a). İleri beslemeli iki ayaklı yürüme politikasında tek bir kritik çıkış ünitesi: Unitree G1 insan formunda tohum değişimi çoğaltması ve mekanizma analizi. Front. Robot. AI, El Yazısı No 1957291.
- Google Scholar
- Makalede kaynağı görüntüle
-
Obaru K. (2026b). İleri beslemeli iki ayaklı yürüme politikasında kapsamlı ancak anatomik yapıya sahip duyusal yedeklilik. Front. Robot. AI, El Yazısı No 1958210.
- Google Scholar
- Makalede kaynağı görüntüle
-
Ong C. F. Geijtenbeek T. Hicks J. L. Delp S. L. (2019). Ayak bileği plantar fleksör kas zayıflığı ve kontraktüründen kaynaklanan yürüme uyumlarını fizik temelli kas-iskelet simülasyonları kullanarak tahmin etme. PLoS Comput. Biol. 15, e1006993. 10.1371/journal.pcbi.1006993
- Pubmed Özeti
- CrossRef
- Google Scholar
- Makalede kaynağı görüntüle
-
Peng X. B. Andrychowicz M. Zaremba W. Abbeel P. (2018). “Dinamik rastgeleştirme ile robotik kontrolün simülasyondan gerçeğe aktarımı,” IEEE International Conference on Robotics and Automation (ICRA) içinde. 10.1109/ICRA.2018.8460528
- CrossRef
- Google Scholar
- Makalede kaynağı görüntüle
-
Radosavovic,I.Xiao,T.Zhang,B.Darrell,T.Malik,J.Sreenath,K. (2024). Real-world humanoid locomotion with reinforcement learning. Sci. Robot.9, eadi9579. 10.1126/scirobotics.adi9579
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
Rudin,N.Hoeller,D.Reist,P.Hutter,M. (2022). “Learning to walk in minutes using massively parallel deep reinforcement learning,” in Proceedings of the 5th Conference on Robot Learning (CoRL 2021). PMLR164, 91–100. 10.48550/arXiv.2109.11978
- CrossRef
- Google Scholar
- View reference in article
-
Schulman,J.Wolski,F.Dhariwal,P.Radford,A.Klimov,O. (2017). Proximal policy optimization algorithms. arXiv:1707.06347. 10.48550/arXiv.1707.06347
- CrossRef
- Google Scholar
- View reference in article
-
Todorov,E.Erez,T.Tassa,Y. (2012). “MuJoCo: a physics engine for model-based control,” in IEEE/RSJ International Conference on Intelligent Robots and Systems, 5026–5033. 10.1109/IROS.2012.6386109
- CrossRef
- Google Scholar
- View reference in article
-
Weerdesteyn,V.de Niet,M.van Duijnhoven,H. J. R.Geurts,A. C. H. (2008). Falls in individuals with stroke. J. Rehabil. Res. Dev.45, 1195–1213. 10.1682/JRRD.2007.09.0145
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
Zakka,K.Liao,Q.Yi,B.Le Lay,L.Sreenath,K.Abbeel,P. (2026). Mjlab: a lightweight framework for GPU-accelerated robot learning. arXiv:2601.2207410.48550/arXiv.2601.22074
- CrossRef
- Google Scholar
- View reference in article
Summary
Keywords
actuator command degradation, cross-seed replication, fall threshold, graded ablation, humanoid locomotion, reinforcement learning, robustness, simulation
Citation
Obaru K (2026) A quantitative fall threshold for graded unilateral motor-command attenuation in a simulated feedforward humanoid locomotion policy. Front. Robot. AI 13:1959239. doi: 10.3389/frobt.2026.1959239
Başvuru
05 Ağustos 2026
Düzeltme
01 Ekim 2026
Kabul
22 Ekim 2026
Yayınlanma
11 Kasım 2026
Cilt
13 – 2026
Kensuke Harada, Osaka Üniversitesi, Japonya
Shubham Singh, The University of Texas at Austin, Amerika Birleşik Devletleri
Andrea Vitali, Bergamo Üniversitesi, İtalya
© 2026 Obaru.
Bu, Creative Commons Atıf Lisansı (CC BY) koşulları altında erişime açık bir makaledir. Orijinal yazar(lar)ın ve telif hakkı sahib(lar)ının belirtilmesi ve yerleşik akademik uygulamaya uygun olarak bu dergideki orijinal yayının atıf edilmesi şartıyla, diğer platformlarda kullanım, dağıtım veya çoğaltma izinlidir. Bu koşullara uymayan herhangi bir kullanım, dağıtım veya çoğaltma izinlidir.
*İletişim: Kenshi Obaru, research@rehabiliworld.com
†
ORCID: Kenshi Obaru, orcid.org/0009-0002-1899-1909
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, ya da yayıncının, editörlerin ve değerlendirenlerin görüşlerini kesin olarak temsil etmeyebilir. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
Yorumlar