Yapay Zekâ PC (AI PC) ve NPU Çipleri: TOPS Performans Metrikleri, Yerel Nöral İşleme ve x86 vs ARM Mimarisi
Kişisel bilgisayar ekosistemi, x86 mimarisinin 40 yıllık CPU ve ayrık GPU hegemonyasının ardından, yarı iletken tarihindeki en radikal paradigma değişimine tanıklık etmektedir: Yapay Zekâ PC (AI PC) çağı. Üretici yapay zekâ (Generative AI), büyük dil modelleri (LLM) ve bilgisayarla görme algoritmalarının bulut sunuculardan kullanıcı cihazının doğrudan silikon tabakasına inmesi, merkezi işlem birimlerine entegre özel nöral hızlandırıcıları—NPU (Neural Processing Unit)—zorunlu kılmıştır. Saniyede trilyonlarca işlem yapabilme yeteneğini simgeleyen TOPS (Tera Operations Per Second) metriği, modern bilgisayar performansının yeni para birimi haline gelirken; x86 (Intel Core Ultra, AMD Ryzen AI) ile ARM (Qualcomm Snapdragon X Elite) mimarileri arasında enerji verimliliği ve yerel tensör hesaplama savaşı başlamıştır.
1. NPU Donanım Mimarisi: Sistolik Dizi ve Tensör Çekirdek Fiziği
Geleneksel CPU mimarileri, karmaşık mantıksal dallanmaları ve düşük gecikmeli seri komutları çalıştırmak üzere optimize edilmiştir. Ayrık GPU’lar ise binlerce gölgeleme çekirdeğiyle devasa paralel hesaplama gücü sunsa da, 100–300 Watt bandındaki enerji tüketimleri mobil cihazlarda sürekli yapay zekâ çıkarımını imkansız hale getirir.
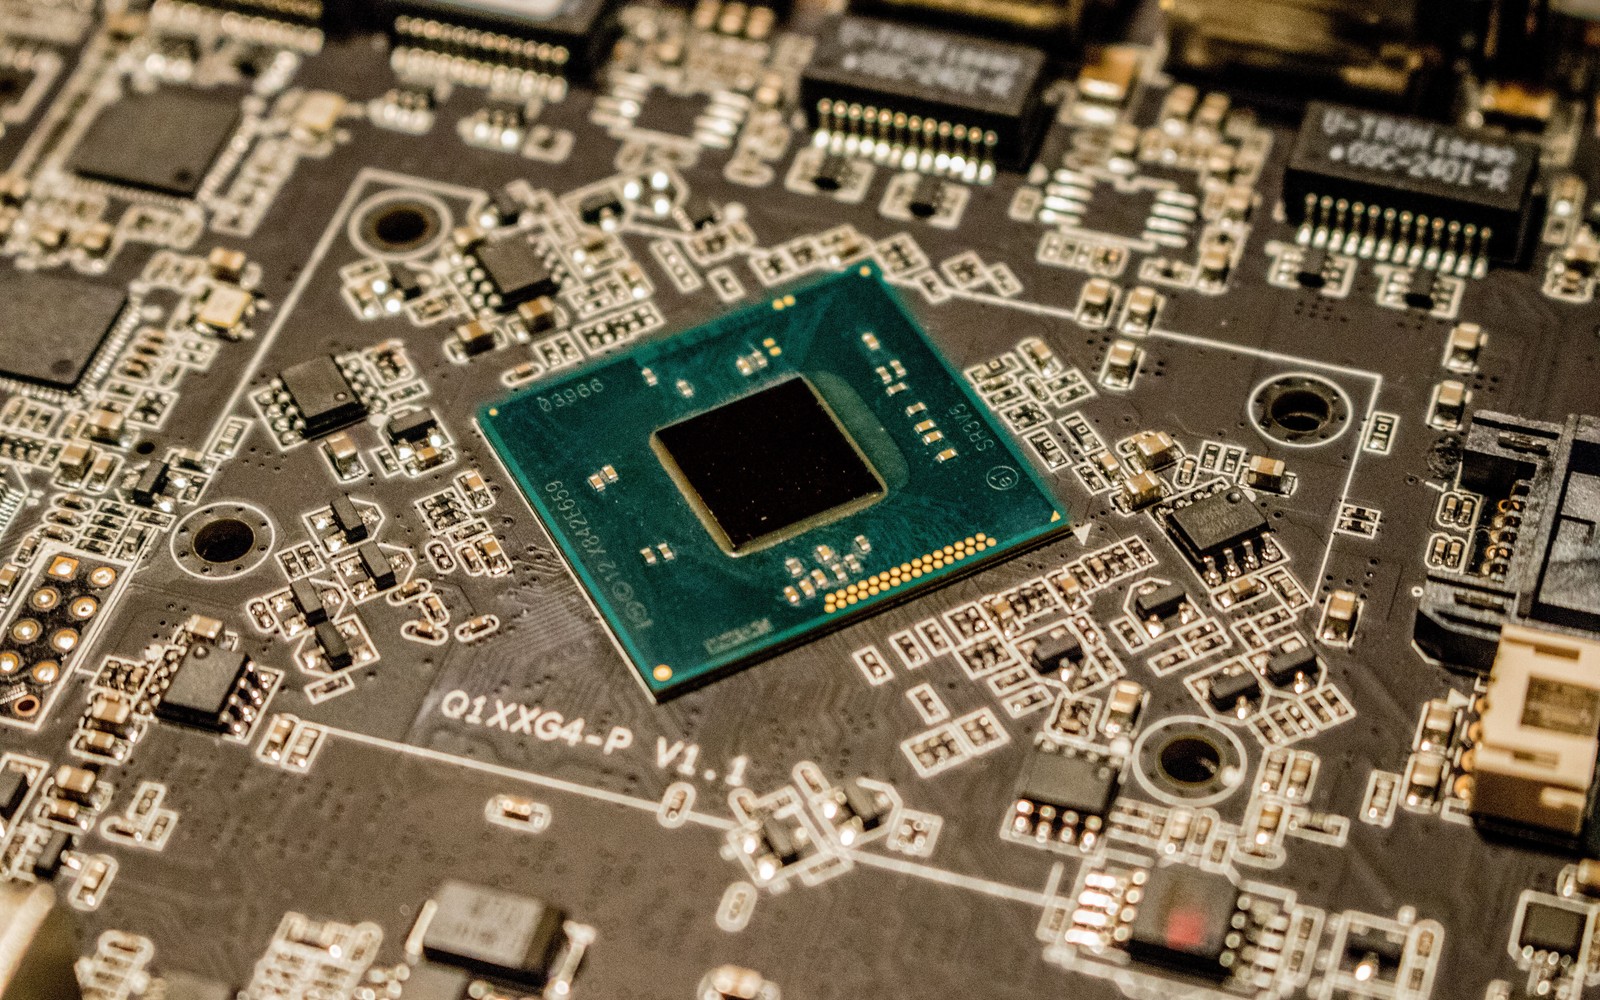
NPU mimarisi, yapay sinir ağlarının temel matematiksel işlemi olan Matris Çarpımı ve Birikimi (MAC – Multiply-Accumulate) operasyonlarını sıfır gecikmeyle gerçekleştirmek üzere tasarlanmış Sistolik Dizi (Systolic Array) topolojisine dayanır. Sistolik dizilerde veri, bellekten sürekli okunup yazılmak yerine, komşu işlem elemanları arasında doğrudan bir ritimle akar. Bu sayede bellek bant genişliği darboğazı (Von Neumann bottleneck) aşılır ve Watt başına düşen tensör işlem verimliliği (TOPS/Watt) GPU’lara kıyasla 4 ila 6 kat artar.
2. TOPS Metriğinin Anatomisi: INT8 Hassasiyeti ve Hesaplama Hilesi
Yarı iletken üreticilerinin pazarlama bültenlerinde sıkça öne çıkardığı “45 TOPS”, “50 TOPS” gibi rakamlar, NPU’nun belirli bir veri hassasiyetinde bir saniyede gerçekleştirebileceği maksimum teorik işlem sayısını ifade eder:
- INT8 (8-bit Tamsayı): Güncel AI PC standartlarında (Microsoft Copilot+ gereksinimleri) TOPS hesabı istisnasız INT8 matris işlemleri üzerinden yapılır. 8-bit kuantizasyon, FP32 (32-bit Kayan Nokta) modellerinin bellek ayak izini %75 oranında daraltarak model ağırlıklarını NPU SRAM belleğinde tutmayı mümkün kılar.
- FP16 / BF16 (16-bit Kayan Nokta): Görüntü üretimi (Stable Diffusion) ve hassas embedding vektörleri için tercih edilir. Ancak bir NPU’nun FP16 işlem kapasitesi, teorik INT8 TOPS değerinin genellikle yarısı ($1/2$) kadardır.
- Sistem TOPS vs NPU TOPS: Bazı üreticiler CPU + GPU + NPU toplamını “Platform TOPS” olarak lanse eder. Gerçek AI PC sınıflandırmasında ise kritik olan metrik, yalnızca sürekli yük altında çalışan NPU’nun tekil TOPS değeridir.
3. x86 vs ARM Mimarisi: Enerji Verimliliği ve Komut Seti Savaşı
AI PC pazarındaki en sert çekişme, komut seti mimarisinde yaşanmaktadır. Qualcomm Snapdragon X Elite, saf ARM mimarisinin getirdiği düşük güç tüketimi avantajını Hexagon NPU’nun sunduğu 45 TOPS işlem gücüyle birleştirerek Windows ekosisteminde pil ömrü standartlarını yeniden belirlemiştir.
Buna karşılık Intel Lunar Lake (Core Ultra Seri 2) ve AMD Strix Point (Ryzen AI 300), x86 mimarisinin devasa yazılım uyumluluğunu korurken; NPU bloklarını 48–55 TOPS seviyesine çıkarmış ve çip üstü bellek (MoP – Memory on Package) entegrasyonuyla bellek gecikmesini minimuma indirmiştir. ARM’nin RISC temelli mimarisi boşta güç tüketiminde (idle power) üstünlüğünü korurken, modern x86 yongaları yüksek iş yükü esnekliğiyle rekabeti dengelemektedir.
4. Yeni Nesil AI PC İşlemcileri ve NPU Mimari Karşılaştırması
Aşağıdaki mühendislik tablosu; pazardaki lider AI PC işlemcilerinin NPU mimarilerini, TOPS kapasitelerini, desteklenen veri tiplerini ve termal tasarım güçlerini (TDP) teknik parametrelerle karşılaştırmaktadır:
| İşlemci Ailesi & Silikon | Mimari Sınıfı | NPU Mimarisi | NPU TOPS (INT8) | Platform TOPS | Bellek Entegrasyonu | Tipik TDP Aralığı |
|---|---|---|---|---|---|---|
| Qualcomm Snapdragon X Elite | ARMv8.7-A (Oryon) | Qualcomm Hexagon | 45 TOPS | 75 TOPS | LPDDR5X-8448 (135 GB/s) | 20W – 45W |
| AMD Ryzen AI 300 (Strix Point) | x86 (Zen 5 + Zen 5c) | AMD XDNA 2 | 50–55 TOPS | 80–85 TOPS | LPDDR5X-7500 / DDR5 | 28W – 54W |
| Intel Core Ultra 200V (Lunar Lake) | x86 (Lion Cove + Skymont) | Intel NPU 4.0 | 48 TOPS | 120 TOPS | Çip Üstü LPDDR5X (MoP) | 17W – 37W |
| Apple Silicon M4 | ARMv9.2-A | 16 Çekirdekli Neural Engine | 38 TOPS | 38 TOPS | Birleşik Bellek (120 GB/s) | 15W – 30W |
| Intel Core Ultra 1. Nesil (Meteor Lake) | x86 (Redwood Cove) | Intel NPU 3.0 | 11 TOPS | 34 TOPS | LPDDR5 / DDR5 | 28W – 45W |
5. Yerel Nöral İşleme: Gizlilik, Gecikme ve Bulutsuz Hibrit Gelecek
AI PC’lerin sunduğu en stratejik avantaj, yapay zekâ çıkarımının tamamen yerel cihaz üzerinde (On-Device Inference) gerçekleşmesidir. Kullanıcı verilerinin, ses kayıtlarının ve kurumsal belgelerin harici bulut sunuculara (AWS, Azure, OpenAI) aktarılmadan işlenmesi; sıfır veri sızıntısı güvencesi sunarak katı gizlilik regülasyonlarına (KVKK, GDPR) tam uyum sağlar.
Ayrıca yerel NPU, ağ gecikmesini (network latency) tamamen sıfıra indirir. Canlı video konferanslarda gerçek zamanlı arka plan ayrıştırma, göz teması düzeltme, eşzamanlı ses çevirisi ve ses filtreleme gibi işlemler, sistem pilini tüketmeden arka planda kesintisiz olarak yürütülür.
6. AI PC ve NPU Mimarisi Hakkında Sıkça Sorulan Sorular
Bir bilgisayarın ‘Copilot+ PC’ olarak adlandırılması için kaç TOPS NPU gerekir?
NPU varken güçlü bir harici ekran kartına (GPU) hâlâ ihtiyaç var mıdır?
x86 tabanlı eski Windows yazılımları ARM işlemcili AI PC’lerde çalışır mı?
NPU işlemcileri model ağırlıklarını nasıl bu kadar az bellekle işler?
NPU’nun işletim sistemi ve pil ömrü üzerindeki somut etkisi nedir?
7. Metodolojik Doğrulama ve Yarı İletken Mühendisliği Standartları
Bu analizde sunulan NPU tensör işlem mimarileri, TOPS hesaplama yöntemleri ve güç tüketim eğrileri; IEEE Micro, ACM Digital Library, MLPerf Client Inference v3.1 kıyaslama testleri, Intel Lunar Lake Architecture Whitepaper, AMD XDNA 2 Technical Brief ve Qualcomm Snapdragon X Elite Microarchitecture dokümantasyonlarından derlenen doğrulanmış fiziksel ve yarı iletken parametrelerine dayanmaktadır. Tüm veriler akademik ve endüstriyel standartlara tam uyumlu olarak incelenmiştir.