DERLEME Makalesi
Front. Digit. Health, 12 Kasım 2026
Ed. İnsan Faktörleri ve Dijital Sağlık
Cilt 8 – 2026 | https://doi.org/10.3389/fdgth.2026.1901454
- AT
Andreas Triantafyllopoulos 1,2*
- YT
Yannik Terhorst 3,4
- IT
Iosif Tsangko 1,2
- FB
Florian B. Pokorny 1,2,5
- KD
Katrin D. Bartl-Pokorny 1,5
- LS
Lennart Seizer 1,4,6
- AK
Ayal Klein 7
- JC
Jenny Chim 8
- DA
Dana Atzil-Slonim 9
- ML
Maria Liakata 8
- MB
Markus Bühner 3,4
- JL
Johanna Löchner 4,6
- BS
Björn Schuller 1,2,10
-
1. CHI—Sağlık Bilgisybilimi Kürsü, Münih Teknik Üniversitesi, Münih, Almanya
-
2. MCML—Münih Makine Öğrenimi Merkezi, Münih, Almanya
-
3. Psikoloji Bölümü, Ludwig Maximilian Münih Üniversitesi, Münih, Almanya
-
4. Alman Ruh Sağlığı Merkezi (Deutsches Zentrum für Psychische Gesundheit), Münih-Augsburg ortak sitesi, Almanya
-
5. Yeni Doğan Ünitesi, Graz Tıp Üniversitesi, Graz, Avusturya
-
6. Birincil Bakımda Ruh Sağlığı Kürsü, Genel Pratik ve Aile Hekimliği Enstitüsü, Ludwig-Maximilians-Üniversitesi, Münih, Almanya
-
7. Bilgisayar Bilimi Fakültesi, Ariel Üniversitesi, Ariel, İsrail
-
8. Elektronik Mühendisliği ve Bilgisayar Bilimi Fakültesi, Londra Queen Mary Üniversitesi, Londra, Birleşik Krallık
-
9. Psikoloji Bölümü, Bar-Ilan Üniversitesi, Ramat Gan, İsrail
-
10. GLAM—Dil, Ses ve Müzik Araştırma Grubu, Imperial College, Londra, Birleşik Krallık
Makale metrikleri
Dijital teknolojiler uzun zamandır ruh sağlığı araştırmaları ve uygulamasında standart yaklaşımın bir tamamlayıcısı olarak, elektronik sağlık kayıtlarının yönetiminden uygulama tabanlı müdahalelere kadar geniş bir yelpazede inceleniyor. Büyük dil modellerinin (LLM’ler) hem ticari hem de açık kaynaklı olan son dönemdeki yaygınlaşması, bu alanda önemli yeni bir fırsat temsil ediyor. Yine de LLM’ler geliştiren toplulukla, bundan yararlanabilecek topluluk arasında hâlâ bir uçurum bulunuyor ve bu da teknolojinin klinik uygulamaya dönüştürülmesini zorlaştırıyor. Bu uçurum büyük ölçüde teknolojinin iç işleyişi, yetenekleri ve riskleri konusundaki ortak dil ve anlayış eksikliğinden kaynaklanıyor. Bu, güncel LLM’lerle ilgili temel kavramların ardındaki sezgisel açıklamaları sağlayarak bu açığı kapatmayı amaçlayan, eğitim niteliğinde bir derleme sunuyor.
1. Giriş
Mental bozukluklar, dünya çapında hastalık yükünün başlıca nedenleri arasında yer almakta ve 2030 yılına kadar küresel engelliye indirgenmiş yaşam yılılarının (DALY) en büyük nedenine dönüşmesi öngörülmektedir [–]. Bu zorluğa karşı, mental sağlık bakımında teknolojik yeniliklere büyük ihtiyaç bulunmaktadır [, –]. Son otuz yılda internet ve mobil tabanlı müdahaleler kapsamlı biçimde araştırılmış; geleneksel yüz yüze psikoterapiyle karşılaştırıldığında umut verici sonuçlar göstermiş [, , ,] olsa da kullanıcı kabulü ve uyum orta düzeyden düşük düzeydedir [–]. Bu sorunu çözmek amacıyla, nispeten yeni ortaya çıkan büyük dil modelleri (LLM’ler)—doğal dili işleyip üretebilen modeller—ve doğal dil işleme (NLP) alanında çeşitli görevlerde gösterdikleri etkileyici performans, mental sağlık uygulamasını desteklemek ve tamamlamak amacıyla ortaya çıkan en eski teknoloji temelli fikrlerden biri olan konuşma ajanlarına [–] yeniden ve olağanüstü derecede geniş bir kamu ve ticari ilgi uyandırmıştır. ELIZA, 1966 yılında önerilen ilk böyle bir konuşma ajanı (“chatbot”) olmuş; insan kullanıcının sağladığı metin girdisi üzerinde işleyen ve Rogerian psikolojinin temel ilkelerine sadık kalarak konuşmayı sürdüren bir dizi kuraldan oluşmaktaydı. Doğası gereği ELIZA, insan kullanıcının sağladığı metni yeniden işleyip kullanıcıyı bunun üzerine daha fazla konuşmaya yönlendiren bir soruya dönüştürmeyle sınırlıydı. Bunun ardından chatbotlara dair çalışmalar, depresif belirtileri ve psikolojik stresi azaltmada ilk umut verici sonuçları göstermiş [, ] ve mental sağlık hedefli konuşma platformları—Woebot gibi—zaten hastalara sunulmaktadır.
Araştırma ve hesaplama yetenekleri o ilk günlerden bu yana önemli ölçüde ilerlemiştir; ChatGPT veya Claude gibi güncel sürümler daha doğal, uçtan uca konuşmalar yürütebilmektedir. Bu durum, söz konusu modellerin mental uygulama alanındaki olası kullanımına dair büyük bir heyecan yaratmıştır. Özellikle, bu modellerin kullanımını milyonlarca kullanıcıya ölçeklendirebilme yeteneği ve anında erişilebilirliği onları dijitalleştirilmiş müdahaleler için en umut verici araştırma alanlarından biri yapmaktadır [].
Buna rağmen, etraflarını saran heyecana rağmen, LLM’leri geliştiren teknik topluluk ile bunlardan klinik uygulamada yararlanabilecek sağlık topluluğu arasındaki eksik etkileşim ve karşılılı anlaşılmadan kaynaklanan belirli giriş engelleri hâlâ mevcut. Bir yandan, psikologlar ve psiyatristlerin bu güncel sistemler hakkındaki teknik anlayışındaki belirgin boşluğun yanı sıra, kötüye kullanıma ilişkin isteksizlik veya korkuda bulunuluyor []. Diğer yandan, teknoloji tarafında da aynı derecede tehlikeli bir boşluk var; çünkü uzmanlar psikoli bilimini, klinik uzmanların ihtiyaçlarını ve araçlarının olası risklerini görmezden gelebilir []. Bu katkıda, bu bölünmenin bir tarafını—yani terapist araştırmacıları ve uygulayıcılarının bu modellerin olanakları ve olası eksiklikleri konusundaki sınırlı anlayışını—köprülemeye çalışıyoruz. Aynı zamanda, bu kitlenin bu yeni teknolojileri klinik uygulamalarında kullanma konusundaki özgüvenini artırmayı ve hastaların kendilerinin (kendi inisiyatifiyle) gerçekleştirdiği istenmeyen kullanımın kendi kendine yardım stratejilerini nasıl etkileyebileceğini daha iyi anlamayı hedefliyoruz. Bu amaçla, mümkün olduğunca az teknik terimle, modellerin temel çalışma ilkelerinin kısa ve öz bir özetini sunuyoruz. Kritik öneme sahip bir nokta olarak, bu modellerin çalışma mantığının ardındaki temel varsayımlardan bazılarını vurguluyoruz; özellikle心理健康 alanıyla ilgili olanlar öne çıkıyor.
Bu bağlamda, öncelikle LLM’lerin (ve genel olarak sohbet botlarının) dil temelli müdahaleleri (yarı) otonom bir şekilde gerçekleştirmedeki kullanımına odaklanıyoruz. 2. bölümde LLM’ler için olası uygulama alanlarını kısaca özetlesek de, alanın genel yönünü göz önünde bulundurmak gerekiyor—mevcut büyük araştırma çabaları, LLM’lerin konuşma ve metin analizini birlikte yürütebilen genel amaçlı araçlar olarak kullanımının iyileştirilmesine yönelik. Bu araştırma gündeminin özünü, LLM’leri betimlemek için kullanılan “temel modeller” teriminin kullanımı özetliyor; yani çeşitli uygulamalar için temel yapı taşları olarak hizmet veren modeller olarak.
Her durumda, LLM’lerin insanları yetlendiren—insanların yerini alan değil—bir teknoloji olarak rolüne odaklanıyor ve nihai amacımız hastalardaki sonuçları iyileştirmek olup, kendimizi poliklinik ortamıyla sınırlıyoruz. Tartışmamız, bu iyileştirmenin nasıl tanımlandığı veya ölçüldüğü (örneğin standart bir değerlendirme yoluyla), tedavinin nasıl reçete edildiği (örneğin danışman bir psikoterapist tarafından) veya izlenen hangi düşünce okuluna (örneğin bilişsel davranışçı terapi (BDT), psikodinamik yaklaşımlar veya başka) ait olduğu konusunda tarafsız kalyor. Bunun yerine, açıkça bu hedefle ilgili görevlerin nasıl yerine getirileceğine odaklanıyoruz. Ayrıca, klinik ortama yerleştirilmeden önce olası sınırlamalarını ve bunların nasıl aşılabileceğini tartışıyoruz. Bu kapsamda, bir sonraki bölümde LLM’ler için olası uygulamaları tanıtarak başlıyor, ardından iç işleyişlerini tartışıyoruz.
Öğretici derlememizin, LLM’lerin arkasındaki teknolojiye ilişkin daha erişilebilir bir dille tanışmak isteyen, sağlık alanında arka plana sahip okuyucular için en büyük faydayı sağlayacağını belirtiyoruz. Bununla birlikte, teknoloji geliştiricileri ile sağlık uygulayıcıları arasındaki boşluğu kapatmayı ve bu iki topluluğun diyalog kurmasının gerekliliğini sürekli olarak vurgulamayı da hedefliyoruz. Bu nedenle çalışmalarımız, çalışmalarını sağlık alanına uygulamak isteyen LLM araştırmacıları için de bir giriş noktası işlevi görebilir. Bu bağlamda, makalemizin, paralel olarak yürütülen çok sayıda derleme çalışmalarına tamamlayıcı olması umudundayız. Özellikle makalemiz, önceki çalışmalarda LLM kullanımını belgeleyen mevcut tarama ve sistematik derlemeleri [–] ve bu alanda LLM kullanımını tartışan diğer anlatısal derlemeleri ve yorumları [– 31] destekler niteliktedir. Çalışmamız, LLM’lerin geliştirilmesinde yer alan teknik ayrıntılara dair daha derin bir genel bakış sağlayarak bu diğer derlemeleri temellendiriyor.
2. LLM’lerin sağlık alanındaki uygulamaları
Şekil 1, dil modellerinin ruh sağlığı araştırmacıları ve uygulayıcılarının günlük pratiğinde olası kullanım alanlarını göstermektedir. Buradan, sohbet botlarının mevcut kullanımını kapsayan Bendig ve arkadaşlarının güncel derlemesinden ilham alıp dil modellerinin yerine getirebileceği görevlerle genişletmiş; ancak bunun ötesine geçerek olası kullanım alanlarının daha geniş bir çeşitliliğini sergilemiştik. Görevleri genel olarak terapiste yönelik ve hastaya yönelik görevler olarak ayırmaktayız. Therapist-facing görevler “arka planda” yürütülür, yani modeller hastalarla etkileşime girmez. Bir terapist, not alma veya hasta-terapist görüşmelerini özetlemeye yardımcı olmak için bir dil modeli kullanabilir [ 32 ]; ya da yaklaşan bir psikoterapi seansına hazırlanmak amacıyla gerçek hastaların yerine geçebilecek bir rol yapma aracı olarak onu kullanabilir; bu uygulama bazı araştırmacılar tarafından değerlendirilmektedir [ 33 ]. Ayrıca bir dil modelini bir psikoterapi seansındaki “başarılarını” “değerlendirmek” için kullanabilirler [ 34 ]; burada dil modellerini başarının nesnel bir ölçümü olarak kullanmaktan söz etmiyoruz, bunun yerine zaten gerçekleşmiş bir görüşmeye etkileşimli olarak geri bildirim sağlayabilecek veya alternatifler önerebilecek bir araçtan. Figure 1
Bir LLM ajanının hastanın antidepresan ilacını bırakma niyetine verdiği varsayımsal bir yanıt Figure 2’de gösterilmiştir. Çıktı, hastanın öyküsüne ve belirli bir terapi planına bağlı olabilecek farklı özelliklere uyacak biçimde koşullanabilir.
Figure 2
Mavcut amacımız psikologlar ile model geliştiricileri arasındaki boşluğu kapatmak olduğundan, Figure 3’te (solda) LLM model geliştiricilerinin tipik iş akışını ayrıca sunuyor ve kliniklerin LLM’leri pratiğe nasıl entegre edebileceğine dair önerilerimizi paylaşıyoruz. Doğal olarak, iki topluluğun, mevcut modellerin zayıf yönlerini birlikte belirleyip bunları aşmak için birlikte çalışarak, klinik pratiğe dönüşen LLM’lerin geliştirilmesinde yoğun şekilde etkileşime girmesini bekliyoruz.
Figure 3
Geliştiriciler LLM’lerle ne yapıyor?—Model geliştiricileri, model oluşturma ve doğrulama sürecinde altı aşamadan geçer. İlk üç aşama, bir modelin nasıl eğitildiğine karşılık gelir ve Bölüm 3.2’de daha ayrıntılı tartışılmaktadır. Son üç aşama ise doğrulama ve iyileştirmenin sürekli bir döngüsüne karşılık gelir. Ticari ürünlerde bunun LLM kullanıcıları tarafından elde edilen verilerin kullanılmasıni de içerdiğini unutmayın. Bu, mental sağlık hastaları ve terapistleri için açık mahremiyet sonuçları taşır ve böyle modeller kullanırken dikkate alınmalıdır. Yerel altyapıda çalıştırılabilecek açık kaynaklı modeller durumunda ise bu her zaman söz konusu değildir.
Psikologlar LLM’lerle ne yapmalı—Ayrıca, LLM’leri klinik uygulamalarında kullanmak isteyen psikologlar için geçici bir 6 adımlı süreç öneriyoruz. Kapsamlı bir yönerge setinden çok uzak olsak da, modellerin nasıl üretildiği tartışılmadan önce bunların nasıl kullanılması gerektiğine dair nasıl yaklaşılması gerektiğini vurgulamayı gerekli görüyoruz. İlk adım, bir LLM’nin uygulanacağı bağlamın belirlenmesi olmalıdır (belki Makale 1’de gösterilen olası uygulamalardan ilham alınarak). Bu, model performansına ilişkin gereksinimleri belirleyecektir (örneğin, not özeti, hastaya geri bildirim vermekten daha az kritik öneme sahiptir). Bunun ardından psikolog, önceden eğitilmiş ve halka açık bir temel model belirlemelidir. Günümüz örnekleri arasında şunlar yer alır: ChatGPT (ticari), Claude (ticari) veya Llama (açık kaynaklı; ticari bir kuruluş tarafından eğitilmiş). İdeal olarak seçim, aday kullanıcının erişimine açık veriler kullanılarak model yeteneklerinin titiz bir değerlendirmesine dayanmalıdır. Açık gizlilik sonuçları bir kez daha göz önünde bulundurun—bu değerlendirme, verilerin bir dış kuruma bilinçdışı şekilde açığa çıkarılmadan yapılmalıdır, yani model yerel bilgisayar altyapısı içinde kullanılmalıdır. İsteğe bağlı olarak—ve belirli bir teknik uzmanlık varsayımıyla—seçilen model kendi verileri üzerinde ince ayar (finetune) edilebilir. Kesinlikle gerekli olmasa da, bu süreç yerel alana uyumlanarak model performansını artırabilir (örneğin, belirli bir pratikde karşılaşılan hastalardaki özgün özelliklerin dikkate alınması gibi). Bir model seçildikten ve ince ayarı yapıldıktan sonra, modelin belirli bir görevi belirli bir şekilde yerine getirmesi için gereken istemi (prompt) belirlemek gerekir. İstemler 3.3.1 bölümünde açıklanacak olsa da, Makale 2’de gösterilen talimatlara benzerler. Son olarak, her klinik uzman modelin performansını tutarlı ve eleştirel biçimde değerlendirmeli ve klinik kullanım için ek koruyucu önlemler (guardrails) kurmalıdır. Örneğin, tanıyı tamamen bir modele devretmeyi önermiyoruz.
2.1 LLM kullanım alanlarının anlaşılması
Bu alt bölümde, Şekil 1’de sunulan farklı potansiyel LLM kullanım alanlarına daha yakından bakıyoruz. Amacımız, farklı uygulama alanları için geçerli olabilecek farklı hususlar konusunda paydaşları bilgilendirmek. Bu, LLM’lere yönelik herhangi bir tavsiye ya da karşıt görüş olarak değerlendirilmemelidir. Bu sorunun cevabı için, tıp biliminin diğer tüm sorularında olduğu gibi, uzlaşıya varmak amacıyla özel çalışmalar ve yapılandırılmış meta-analizlere ihtiyaç vardır. Varsa, hekimlere tavsiyemiz ya bu sonuçları beklemek ya da kendilerinin üretmesidir, çünkü kanıtlar hâlâ eksiktir.
Buna rağmen, farklı uygulamalar için bazı gereksinimlerin gözden geçirilmesi eğitim açısından değerlidir. Bu, ruh sağlığı uzmanlarının ve LLM geliştiricilerinin, mevcut LLM yetenekleri ile gerçek klinik ortamlardaki gelecekteki kullanımları arasındaki boşluğu doldurmak için neye ihtiyaç olduklarını anlamalarına yardımcı olmalıdır. Takip eden alt bölümlerde, çok sayıda tamamlayıcı açıdan—risk nicelleştirme, insan gözetimi, hassasiyet, (ilk aşama) güncel kanıtlar ve kabul için gereksinimler—çoklu bakış açıları üzerinden üç farklı uygulamayı tartışıyoruz.
2.1.1 Otonom psikoterapi seansı
LLM’lerin tam otonom, çok seanslı, 50 dakika süren psikoterapi görüşmelerini yürütmek için kullanımı, LLM araştırmalarının en iddialı, uzun vadeli ve yüksek riskli hedeflerinden biridir [ 40 ]. Bu senaryoyu değerlendiren herhangi bir klinik deney olduğunu şu an için bilmiyoruz ve bunun iyi bir nedeni var: LLM’ler uydurma (hallucination) eğilimindedir ve uzun konuşmalarda tutarlılığı korumakta zorlanır; bu olgu halk arasında bağlam çökmesi olarak bilinir [ 41 ]. Buna göre, bu sistemlerin klinik ortamlarda kullanımına karşı uyarıda bulunuyoruz. Yine de daha kısa etkileşimler zaten pilot olarak denenmiştir. Heinz ve arkadaşları [ 42 ], rastgele kontrollü bir deneyde bir sohbet botu müdahalesinin etkinliğini değerlendirmiş ve bunu bekleme listesi kontrolüne göre daha etkili bulmasıyla en bilinen örnektir.
Otonom tedavi-destek sistemlerinin vaadi ölçeklenebilirlik yeteneğidir: Bu da, yeterli klinik gözetimle klinik iş akışlarına entegre etmeyi zorlaştırır, ancak imkânsız kılmaz. Hastaların izlenmesinde telemedisin uygulamasından elde edilen önceki deneyimler olumlu olmuştur; buradan öğrenilen dersler sağlık alanında da uygulanabilir. Destek araçları, zaten psikoterapi alanına kayıtlı olan hastalara reçete edilebilir; etkileşimleri her seansta tartışılabilir ve bunlardan bazıları uygulayıcıyla paylaşılabilir.
Bununla birlikte, daha yüksek otonom dereceleri çok daha derin etik ve hukuki endişelerle ilişkilidir: Bir şey ters gittiğinde sorumlu kimdir? Sağlık alanında istenmeyen LLM kullanımının yaygınlaştığı bir çağda bu soru son derece günceldir ve LLMlerin klinik iş akışlarına daha fazla entegrasyonu bunu daha da önemli kılacaktır. Bu etik (ve hukuki) boyutu ele almanın tek yolunun ortak tasarım ilkesi olduğuna inanıyoruz: Farklı paydaşların tümü ortak bir uzlaşıya varmalıdır. Bu süreç, sağlık uygulayıcılarını, model geliştiricilerini ve en önemlisi bu araçlardan doğrudan etkilenen hasta derneklerini kapsar.
2.1.2 Rapor özetleme
LLMlerin sağlık alanında, ayrıca daha geniş tıp alanında en yaygın kullanım alanlarından biri not alma ve rapor üretimidir. Tipik bir iş akışı, konuşmadan metne dönüştüren bir modelin, isteğe bağlı konuşmacı ayrıştırma ve konuşma iyileştirme ile birleştirilmesi ve ardından LLM kullanılarak notların birleştirilmesini içerir. Bu yaklaşım zaten ticari ürünlerin bir parçasıdır ve üretkenliği hasta sonuçlarını düşürmeden artırabileceğine dair ön kanıtlar bulunmaktadır [ 43 – 45 ].
Bu kullanım senaryosu genellikle düşük riskli bir durum olarak değerlendirilse de, ilgili riskin miktarının gerçek uygulamaya bağlı olduğunu belirtiyoruz. Kendi hastalarıyla çalışan bir uzman için otomatik not alma sistemlerinin kullanımı gerçekten düşük riskli bir senaryodur; kişisel hafıza, boşlukları doldurabilir ve o hastayla gelecekteki etkileşimlerde hataları düzeltebilir. Ancak otomatik not almanın hastaları farklı uygulayıcılara yönlendirirken kullanılması ciddi sonuçlar doğurabilir: önemli bilgilerin aktarılamaması (düşük geri çağırma), bilgilerin çarpıtılması (düşük doğruluk) veya sahte içerik eklenmesi (halüsinasyonlar) hasta sonuçları üzerinde ciddi etkiler yaratabilir.
Bu, insan katılım derecesinin teknolojinin gerçek uygulamasına bağlı olmasının mükemmel bir örneğidir. Diğer tüm uygulamalarda olduğu gibi dikkatli olmayı savunuyoruz: Otomatik araçların kullanımı yerleşik bir pratik olsa bile, bu, hataların sürece sızamayacağı anlamına gelmez. Bu potansiyel konusunda bilinçli olmak ve oluşturulan notları ve yanıtları proaktif olarak taramak, bu tür araçların klinik iş akışlarına entegrasyonunun bir parçası olmalıdır.
2.1.3 Terapistlere geri bildirim
Bilgisayar destekli terapist geri bildirim ve eğitim araştırmaları yerleşik bir alandır [ 46 ]. LLM’ler, mevcut sistemleri tamamlayan veya hatta bunların yerini alabilecek umut verici bir araç olarak görülüyor [ 47 ]. Bu sistemlerin değerlendirmesi öncelikle sonuca dayalıdır: Bir sistem, en azından bazı terapistler için hasta sonuçlarını iyileştirip iyileştirmediğine göre değerlendirilir. Geri bildirim ve eğitim sistemleri klinik açıdan genellikle düşük riskli olarak görülse de (hastalar bundan doğrudan etkilenmez), göz önünde bulundurulması gereken birkaç yapısal risk vardır. Eğitimde LLM kullanımının artması, beceri kaybına, artan bağımlılığa veya h öğrenmeyi bile engelleyebilir [ 48 ]. Bu risklerin değerlendirmesi, eğitimde LLM kullanımına dair daha geniş literatürün temel varsayımı altına düşer.
Görüşümüz, bunun titizlikle değerlendirilebilecek en zor uygulamalardan biri olduğu yönünde. Yapay zekâ modellerinin kullanımı o kadar yaygındır ki, eğitim amaçlı kullanımının rastgele kontrollü bir deneyde değerlendirilmesi neredeyse imkânsız hale gelir. Bu zorluk, ayrıca böyle bir deneyin sonuçlarının birkaç yıl boyunca izlenmesinin zorunluluğu ile tamamlanır; böylece yapay zekâ modellerinin terapist performansına kısa ve uzun vadeli etkileri anlaşılabilir.
3. Yapay zekâ modellerinin temel çalışma ilkeleri
Yüksek kavramsal düzeyde, yapay zekâ modelleri diğer tüm makine öğrenmesi modelleri gibi belirli bir girdiye uygun bir çıktı üretmeyi hedefler. Yapay zekâ modellerinin özel durumunda, metin girdisi (yani bilinen istek) işleyerek metin çıktısı (yani bilinen tamamlama) üretirler. En basit possible terimlerle bu, tutarlı metin üretebilmeleri anlamına gelir; aşağıda açıklanacağı gibi, bunu özyinelemeli bir biçimde gerçekleştirirler—bir belirteç tek tek üreterek—belirteç basitçe kelime veya kelime parçalarını ifade etmek için kullanılan teknik terimdir.
Çıkları önceki girdilere bağlıdır; genellikle bu girdiler yine metinlerdir; çok modlu modeller giderek geliştirilmesine rağmen, burada metinden metine konuşmalara odaklanacağız. Konuşma amacıyla kullanılan yapay zekâ modellerinin durumunda, bu önceki girdiler hem kullanıcı girdisini hem de yapay zekâ modelinin önceki çıktılarını kapsar; başka bir deyişle, her yeni çıktı o ana kadar süren sohbete bağlıdır (belirli sınırlar içinde; ayrıca aşağıya bakınız).
Kritik olan, bu dil üretimi sürecinin doğası gereği istatistiksel olmasıdır. Her çıktıyı üretmek için yapay zekâ modeli, sözlüğündeki her olası belirteç için istatistiksel olasılığı hesaplar; ardından yüksek olasılıklı bir sonraki belirteci üretir. Bu süreç sonsuza kadar tekrarlanarak istenilen uzunlukta cümleler üretilebilir. Sonraki belirtecin olasılığını tahmin eden fonksiyon, derin bir sinir ağına (DSN) dayanır. Sürecin bütününe dair sezgisel bir açıklama Şekil 4’te gösterilmiştir. Sonraki bölümlerde, bu DSN’lerin nasıl uygulandığı (Bölüm 3.1), nasıl eğitildiği (Bölüm 3.2) ve nasıl kontrol edileceği (Bölüm 3.3) tartışılacaktır.
Şekil 4
3.1 Sinir mimarisi
Bahsedildiği gibi, LLM’ler özünde bir olasılık fonksiyonunu yaklaşımla üretmeye eğitilen DNN’lerdir—ve özellikle LLM’in şu anda ürettiği token dizisinde belirli bir token’ın sıradaki token olarak ortaya çıkma olasılığını. Bu nedenle önce 3.1.1 bölümünde tokenizasyon sürecini, 3.1.2 bölümünde ise otoregresif modelleme paradigmasını tartışacağız. Bunun ardından 3.1.3 bölümünde çoğu modern LLM’in temelini oluşturan DNN mimarisini, son olarak da 3.1.4 bölümünde LLM’lerin hesaplama sınırlarını sunacağız.
3.1.1 Tokenizasyon ve gömme—metni sayıya dönüştürme
Cümleler yan yana dizilen kelimelerden oluşur; her kelime dilin alfabesindeki harflerin birleşiminden (plus noktalama işaretleri, boşluklar, sayılar veya özel karakterler) meydana gelir. Dijital sistemler bu karakterlerin her birini benzersiz bir sayısal temsille ifade eder (örneğin ASCII veya Unicode). En basit durumda bu sayısal temsiller LLM’e girdi olarak kullanılabilir. Ancak karakter düzeyindeki temsiller son derece verimsizdir, çünkü bireysel kelimeleri anlamadan önce farklı karakterler arasındaki ilişkileri öğrenmek gerekir. Bu yüzden çoğu LLM girdi olarak daha yüksek anlamlı bir birim kullanır—buna token denir.
Karakterlerin tam tersi uçta ise kelimeler yer alır. Bireysel kelimeler, LLM’ler için alternatif bir girdi sunar—tek yapılması gereken, her bireysel kelimeyi benzersiz bir sayıyla temsil etmektir. Peki o zaman neden kelimeler yerine tokenlar? Oxford İngilizce Sözlük, “500.000’den fazla kelime (ve deyim)” içeren bir koleksiyona sahiptir ve bu sayı, fiil ve isimlerin alabileceği farklı biçimler (örneğin tekil ile çoğul, fiil çekimleri, zamanlar) hariç tutulmaktadır. LLM’lerin ‘açık dünyalı’ sohbet botları olması—yani olası her konu hakkında sohbet edebilmesi—istendiğinden, bu kelimelerin her birini işleyebilmeleri ve potansiyel olarak üretebilmeleri gerekir; buna göre her kelimeye kendi sayısal temsilini vermek gerekir. Ancak istenilen sözcük havuzunun boyutu, güncel sistemlerin hesaplama yetenekleri için aşırı derecede zorlayıcıdır; özellikle birden fazla dili destekleyecek şekilde eğitilmelerinden dolayı [ 49 ]. Örneğin, Llama-3 modelleri bile “sadece” 120.000 tokenlık bir sözcük havuzuna sahiptir [ 50 ] ve bu, tüm İngilizce dilini kapsamak için yeterli değildir.
Orta yol, kelimelerin alt-kelime birimlerine—o meşhur tokenlara [ 51 ]—bölünmesiyle bulunur. Pratikte, çoğu “sınır” LLM, yaygın kelimelerin çoğunu kapsayan yeterince büyük sözcük havuzu alanlarına sahiptir. Ancak en gelişmiş GPT-4o ve Llama-3 modelleri [ 50 ]—kullanıma açık en gelişmiş iki model—bazı yaygın kelimeyi alt-kelimelere bölecektir [ 50 ]; örneğin Llama-3, 128.000 tokenlık bir sözcük havuzu boyutuna sahiptir [ 50 ]. Örneğin, “antidepressants” kelimesi “antidepress” ve “ants” olarak bölünür. Bu durum, söz konusu LLM’lerin “I want to stop taking my antidepressants” gibi cümlelerle nasıl baş edeceğini etkiler; konuya daha sonra döneceğiz.
İşaretçilere ayrıştırdıktan sonra bu işaretçilerin sayılara dönüştürülmesi gerekir. En basit durumda, alfasayısal olarak sıralanırlar ve her biri için her birini temsil eden bir tamsayı kullanılır—buna o işaretçinin id değeri denir. Ancak işaretçi başına değişmez bir tamsayı temsilini yakalamak için yeterli değildir—işte bu nedenle bu ilk kodlamalar, işaretçi gömmeleri olarak bilinen yüksek boyutlu vektör temsillerine dönüştürülür. Bu vektörler genellikle ondalık sayılardır (şekillerimizin görselleştirme amacıyla tamsayı gösterdiğini unutmayın) ve daha da önemlisi, veriden öğrenilen sayılardır. Yaygın örnekler arasında GloVe gömmeleri [ 52 ] veya word2vec [ 53 ] yer alır. İşte bu vektör temsilleri bir LLM’e girdi olarak verilir ve sonraki çıktı işaretçi için bir tahmin üretmek üzere iç katmanları tarafından işlenir.
3.1.2 Otomatik regresyon modeli—çıktı üretimi
Bir LLM’in amacı, konuşmaların geçmişine göre uygun bir çıktı metni üretmektir. Bu, bir sınır’a ulaşılana kadar bir seferde bir işaretçi üreterek gerçekleştirilir—bu sınır ya LLM tarafından, kendi sırasının tamamlandığını belirten “dizinin sonu” adı verilen bir işaretçi çıkarma seçeneğine sahip olduğu için LLM tarafından, ya da bazı sabitlenmiş kurallar aracılığıyla (örneğin, en fazla 50 işaretçi çıkarma) belirlenir. Üretilen her yeni işaretçi, sıradaki işaretçinin üretilebilmesi için girdi olarak geri beslenir ve böylece devam eder. Süreç ya konuşmanın geçmiş tarihiyle, uygun bir istemle (Bölüm 3.3.1) ya da her ikisinin bir kombinasyonuyla başlatılır. Bu iş akışı Şekil 4’te gösterilmiştir.
Az önce tarif ettiğimiz süreç, genellikle otomatik regresif modellemenin hırsız (greedy) varyantı olarak adlandırılır; her adımda, önceki tüm adımlar verildiğinde en yüksek olasılıklı bir sonraki belirteci seçtiği için hırsız olarak kabul edilir; ancak tüm çıktı dizisi bir bütün olarak ele alındığında bu, her zaman en uygun seçim olmayabilir. Dekodmanın alternatif biçimleri, demet araması (beam search) [ 54 ] varyantlarına dayanır; yani paralel olarak farklı kodlama dizilerini keşfeden ve yalnızca birkaç adım sonra en yüksek olasılıklı diziyi seçen algoritmalar. Şunu belirtmek önemlidir: Önce “uygun yanıtın ne olduğu”na karar veren, ardından onu üreten açık bir düşünce süreci yoktur; bunun yerine LLM’ler, yanıtı yüzeysel, sözcük düzeyinde formüle eden ve önceden açık, iletişimsel bir niyet belirlemeyen sürdürerek düşünme (think-as-you-go) paradigmasını izler. Buradan, LLM’ler tarafından yapılan olası “üst düzey” düşünmeyi ortadan kaldırmak istemediğini, bunun yerine bu üst düzey düşünmenin ancak eğitim verisinin bir yan ürünü olarak ortaya thểbileceğini (veya istem yoluyla açığa çıkarılabileceğini, Bakınız Bölüm 3.3.1) vurgulamak istediğini kastediyoruz; bu konudaki tartışma halen sürmektedir [ 55 ].
3.1.3 Dönüşümcüler—LLM yapı taşları
Çoğu güncel LLM, sözde dönüşümcü (transformer) mimarisine dayanır. Bu, ilk olarak Vaswani ve ark. [ 56 ] tarafından önerilen bir mimaridir. Tekrarlanan bloklarden oluşur; her blok, bir kendine-atif (self-attention) katmanı ve ardından iki katmanlı bir çok katmanlı algılayıcı (multilayered perceptron)—arasında birkaç ek normalleştirme katmanı—içerir. Üst düzey bir genel bakış Şekil 5’te gösterilmiştir. Aşağıda bileşenlerin her birinin rolünü tartışacağız.
Şekil 5
Kendi kendine dikkat (self-attention): Kendi kendine dikkat katmanları aşağıdaki şekilde çalışır. Öncelikle, girdideki tüm belirteçler arasında bir benzerlik kavramı hesaplarlar; buna o anda LLM’nin ürettiği belirteçlerin yanı sıra bu ana kadar geçen tüm konuşma da dahildir. Bu benzerlik kavramı her kendi kendine dikkat katmanı için farklıdır ve eğitim sırasında öğrenilen ağırlıklarla belirlenir; böylece her katman farklı bir benzerlik kavramına özelleşebilir. Örneğin, belirli bir katman anlamsal benzerliğe, başka biri dilbilgisi yönüne (yani bir sıfatın, kendisini nitelediği isme, girdideki diğer tüm belirteçlere kıyasla en yüksek benzerliğe sahip olması gibi) özelleşebilirken, başkası da duygusal benzerliğe özelleşebilir. Belirli olarak, her belirteçin gömülmeleri eğitim sırasında öğrenilen matrislerle çarpılır; bu iki çıktının soru ve anahtar olarak adlandırılır. Ardından, nedenselliği sağlamak için yalnızca cümlede bir sorudan sonra gelen anahtarlar için her soru ile anahtar arasındaki benzerlik hesaplanır. Bu benzerlik puanları dikkat matrisi olarak bilinir.
Son olarak, her belirteçin gömülmeleri öğrenilebilir bir projeksiyon matrisi kullanılarak bir değer kümesine daha ileri projekte edilir; bu değerler ilgili dikkat ağırlıklarıyla çarpılır ve orijinal temsille toplanır. Bu şekilde bilgi, her çiftin karşılıklı benzerliğiyle ağırlıklı olarak her bir belirteçten diğer tüm belirteçlere yayılır; bu da kendi kendine dikkat katmanının çıktısında her belirteçin, diğer tüm (önceki) belirteçlerden ihtiyaç duyduğu ek bilgiyi taşımasını sağlar. Şekil 5’in ilk iki panelinde buna ilişkin bir örnek gösterilmektedir. Orada, son sözcük olan antidepresanlar örneğimizdeki diğer tüm belirteçlerle karşılaştırılır (sol panel) ve bu benzerlik, o sözcüklerin temsillerini temsile eklerken bir ağırlık olarak kullanılır.
Bu, modelin “antidepressants” (antidepresanlar) sözcüğünü tokenizasyon sırasında “antidepress” ve “ants” olarak bölerek yaptığı “hasar”ı “onarabilmesi” için kullandığı mekanizmadır (yukarıda bakınız). Cümlenin geri kalanındaki bağlamı (ve olası olarak önceki cümleleri) kullanarak model, “ants” ile “antidepress” sözcüklerini birbirine bağlar ve bunları yanlışlıkla bölünmüş tek bir sözcüğün bileşenleri olarak yorumlar; “ants” sözcüğünü gerçek karıncalar, “antidepress” sözcüğünü ise bir nicelik belirteci olarak değil.
Çok katmanlı algılayıcı: Her tokenın içeriğine diğer her tokendan bilgi ekleyerek zenginleştiren öz-dikkatten sonra, iki katmanlı lineer bir katman her tokenı bağımsız şekilde işler. Bu katmanlar artık tokenlar arasında bilgi taşıma konusunda özelleşmez; bunun yerine tek bir tokenın içindeki bilgiyi güçlendirmeye odaklanır ve sezgisel olarak klasik NLP’nin daha standart “özellik çıkarma” süreci olarak düşünülebilir; örneğin Linguistic Inquiry and Word Count (LIWC) özellikleri [ 57 ]. Bir token bu tür bir katmandan geçirildiğinde, LLM eğitim sırasında edinmiş olduğu ek dünya bilgisiyle “donatılmış” olur. Örneğin, örneğimizdeki “stop” sözcüğü bir isim yerine fiil olarak yorumlanır ve ardından önündeki bağlamın kalanıyla birleştirildiğinde olumsuz bir anlam taşıdığı şeklinde yorumlanır.
Önemli noktalar: Öz-dikkat katmanları, bir cümledeki farklı tokenları birbirine bağlayarak bu bilgiyi tetikler; algılayıcılar ise bu birleşik bilgiyi daha da bağlamsallaştırır [ 58 ]. Önemlisi, bu işlevin eğitim sırasında sondan sona (end-to-end) biçimde öğrenilmesidir.
3.1.4 Bağlam penceresi–LLM belleğinin sınırları
LLM’lerin uzun sohbetler yürütmesi beklenir; örneğimizde bu, ruh sağlığı hastalarıyla gerçekleştirilir. Yukarıda gördüğümüz gibi, standart LLM mimarisinin belirli bir katmanı, dizinin içindeki her belirteci diğer her belirtecle bağlamaktan sorumludur. Bu, bu modellerin ek bağlam kullanmasına olanak tanır ve LLM’lerin kritik yeteneklerinden birini açar: tüm önceki sohbeti «akılda tutma» yeteneği, ayrıca (olası olarak) geçmişte sohbet ortağı/hastayla yaşanan önceki sohbetler.
İdeal olarak bu bağlam tamamıyla kullanılabilir olmalıdır; ancak pratikte mevcut hesaplama yetenekleriyle sınırlıdır ve temel sorun (bilgisayar) belleğidir. Pratikte, Llama-3 gibi büyük şirketler tarafından işletilen ileri düzey LLM’ler bile 128.000 belirteci aşmayan bir bağlam üst sınırı getirir [ 50 ]. Bilgisayara ilişkin sınırlar sürekli ötelense de, bağlamın artırılması işletme maliyetinde artışla da ilişkilidir. Sonuç olarak bu, günümüz modellerinin temel bir sınırlamasına—sonlu belleklerine—indirgenir. Bu sorunu aşmanın yollarına Bölüm 3.3.2’de değineceğiz.
3.2 Eğitimi
Önceki bölüm, LLM’lerin iç işleyişine bir genel bakış sundu. Bu bölümde, genellikle eğitimlerinde izlenen üç adımlı iş akışını sunuyoruz. LLM eğitiminde sıkça karşılaşılan en yaygın terimlerin bir sözlüğünü Ek’te bulabilirsiniz.
Bununla birlikte, LLM eğitim sürecine dalmadan önce, aşağıda özetlenen aşamaları kavrayan biçimde anlamayı kolaylaştıracak küçük bir hayal gücüne okuyucuyu davet etmek istiyoruz: Birinin psikoterapist olmak istediğini düşünün. Öncelikle dili öğrenmesi gerekir (örneğin, kelimeleri ve dilbilgisini doğal biçimde içselleştirerek). Ancak iyi düzeyde bir dil yeterliliği, yeterli psikoterapi için başlı başına yeterli değildir. Bunun yerine kişi, terapi tekniklerini örnekler ve yönlendirmeler üzerinden inceleyerek özel eğitime tabi tutulur. Son olarak, özel eğitim sürecinden sonra bile kişi, deneyim ve gözetim yoluyla becerilerini geliştirmeye devam edebilir. Kavrayan biçimde bu üç adım (1) genel dili öğrenme, (2) örnekler ve yönlendirmeler üzerinden öğrenerek dili belirli bir görev için geliştirme ve (3) insan geri bildirimiyle ek geliştirmeler, LLM eğitimindeki üç ana aşamaya yansır: (1) gözetimsiz öncelitim, (2) gözetimli ince ayar ve (3) insan geri bildirimiyle güçlendirilmiş öğrenme.
3.2.1 Gözetimsiz öncelitim
LLM’ler, aldıkları girdiye uygun yanıtlar üretmek için en yüksek olasılığa sahip sonraki token’ı—tek tek token’lar halinde—hesaplar. Bunu başarmak için, geçmiş token’ların olası tüm birleşimlerinde bir sonraki token için iyi bir tahmin sunacak şekilde eğitilmeleri gerekir—ideal olarak, mümkün olan tüm geçmiş birleşimler için. Doğal olarak, insan dilinde var olan sayısız birleşim göz önüne alındığında, bu pratikte imkânsızdır. Bu değere yaklaşmak için LLM’ler, devasa metin veri korpuslarında ön eğitilir. Genellikle, çıkarım sırasında kendilerinden istenecek görevi—geçmiş token’lardan oluşan bir dizinin verilmesi durumunda bir sonraki token’ı tahmin etmeyi—yerine getirecek şekilde eğitilirler. Bu onlara çeşitli token birleşimleri için olasılık dağılımını tahmin etme imkânı tanır. Ancak bu, onlara iyi yapılandırılmış, “yüksek olasılıklı” cümleler kurma imkânı verse de, kısıtlanmamış bir üretimle sonuçlanır ve bu üretim, modelin yaratıcılarının onu takip etmesini istediği çıktı türlerine yönlendirilmelidir. Bu işlemin çoğu klinik uygulayıcı için isteğe bağlı olduğuuna dikkat edin (ayrıca Bakınız Şekil 3) ancak önemli düzeyde teknik uzmanlık ve hesaplama kaynağı gerektirir. Pratikte, ön eğitilmiş bir temel modelden başlamanız önerilir [].
3.2.2 Gözetimli ince ayar eğitimi
Bir LLM’nin ilk geliştirme ve ön eğitim aşamasından sonra, performansı genellikle gözetimli ince ayar (finetuning) süreciyle daha da artırılabilir. Bu işlemin özünde, belirli etiketlerle işaretlenmiş veriler yer alır. Başka bir deyişle, önceki aşamanın tersine, LLM’nin üretmesi beklenen bir hedef cümle vardır (ve bu hedefi yine tek tek belirtecikler üreterek oluşturur). Bu hedef diziler, girdi ve çıktı çiftlerinin toplanmasıyla belirlenir; genel bilgi soru-cevap çiftlerinden, LLM’nin taklit etmesi gereken gerçek insan-insan konuşmalarına, hatta kurallar ve sabit şablonlarla üretilmiş çiftlere kadar uzanır (örneğin, “Antidepresanlarımı bırakmayı düşünüyorum” ifadesine “Bunu benimle paylaştığınız için teşekkür ederim” yanıtını verecek bir kural gibi). Eğitimin bu aşaması, tutarlı ve iyi yapılandırılmış dil yanıtları üretebilen ancak her zaman uygun olmak zorunda olmayan bir LLM ile başlar ve belirli girdilerle karşılaştığında belirli biçimde yanıt verecek şekilde koşullanmış bir LLM ortaya çıkar.
Bu aşamanın genellikle talimat ayarı (instruction finetuning) olarak adlandırıldığını belirtiriz; ancak biz bunu, gözetimli ince ayarda kullanılan girdi-çift alt kümesi olarak değerlendiririz. Talimatlar, çıktının nasıl olması gerektiğini kontrol eden daha açık “emirlerdir”; örneğin, bir LLM’ye girdi olarak “basit bir evet/hayır ile yanıt ver” ifadesi verildiğinde “bas bir evet/hayır ile yanıt ver” şeklinde eğitilebilir. Bu, LLM’nin belirli biçimde yanıtlar üretmesi için uyarma (prompting) yapılmasına olanak tanır ve sık sık LLM’leri kontrol etmek için kullanılır (kullanıcının bazen bunun farkında bile olmaması). Bu konuya 3.3.1 bölümünde döneceğiz. Şimdilik şunu belirtmek yeterlidir: Bu gözetimli ince ayar, belirli girdilerin sonucunda özel yanııt kalıpları yerleştirmek için kullanılır ve kapsamı yalnızca talimatlara uymaktan çok daha genişidir.
Buradaki temel varsayım, LLM’nin eğitileceği bir “doğru” girdi-çıktı çiftleri korpusunun varlığıdır. Bu tür korpuslar çoğu zaman, LLM’lerin tahmini görevlerde eğitilmesinde kullanılan, tahmini içeren veri setlerinden oluşturulur (bunların, bu katkıda göz ardı ettiğimiz bir yönü). Ancak, bu korpuslar yukarıda değinilen talimat ince ayarını (instruction finetuning) ve ayrıca belirli konuşma kalıplarını da içerebilir; psikoterapi durumunda bu, gerçek hayat psikoterapi seanslarından alınan sıraları içerebilir.
Son olarak, burada “öğrenme”nin bu bağlamda yine istatistiksel doğada olduğunu belirtiyoruz. LLM’leri belirli çıktıları sadakatle yeniden üretmeye eğitirken, aynı girdi verildiğinde bu çıktının tam olarak yeniden üretileceğine dair bir garanti yok; aslında böyle bir niyet de yok. Bunun yerine, bu adım bir LLM’ye belirli beceriler aktarma girişimi olarak görülebilir; örneğin, belirli bir girdiye belirli bir şekilde yanıt verebilme yeteneği ve bu becerinin uygulamaya konulduğunda benzer girdilere genelleştireceği umuduyla. Bu genelleştirme isteği, sadakat garantileri pahasına gerçekleşir—LLM’lerin istatistiksel modeller olması onların temel bir özelliğidir; ne yazık ki bu, eğitimde gördükleri girdilere zaman zaman doğru kalıpları üretmekte başarısız olabilecekleri anlamına gelir.
Örneğin, depresyonu bir hastanın “Antidepresanlarımı almayı bırakmak istiyorum” cümlesini yazdığı bir durumda, koşulsuz bir LLM, eğitim setinde gördüğü metne benzeyen bir cümleyle yanıt verecektir; bunun ne olacağı dolayısıyla tamamen eğitim için kullanılan veriyle belirlenir. Bu nedenle, LLM’nin çalışma döngüsü sırasında karşılaşması beklenen konuşmaları yakalayan bir eğitim seti hazırlamak temel önem taşır. Ancak, hastanın yanıtının uygun bir prompt (örneğin “Doğrulayıcı ve rahatlatıcı görünen bir şekilde yanıt ver”) ile yan yana getirilmesi, çoğunlukla talimat ince ayarı sırasında görülen prompt/talimat ve girdi kombinasyonuna benzeyen bir yanıt üretecektir.
3.2.3 İnsan geri bildiriminden güçlendirilmiş öğrenme
Gözetimli öğrenme, LLM’lerin doğru cevabın bilindiği durumlarda doğru şekilde yanıt vermesini sağlar. Ancak tüm olası giriş dizileri için bu mümkün değildir. Özellikle bir insan muhatapla yapılan konuşmalarda, olası tüm konuşmaların nasıl görüneceği önceden bilinemez—bilinseydi, baştan itibaren kural tabanlı bir sistem oluşturmak mümkün olurdu. Oysa pratikte, özellikle bir psikoterapi senaryosunda LLM’lerin karşılaşacağı tür konuşmalar tam olarak bunlardır.
Bu sorunu aşmanın yolu, belirli bir yanıtın uygunluğuna dair insan geri bildirimini hangi kesin cevabın verilmesi gerektiği bilinmeden doğrudan toplamaktır. Bu kısa yol, pekiştirmeli öğrenme kullanılarak elde edilir; burada belirli bir yanıt türünü pekiştiren ödülün, geniş bir LLM yanıt kümesi üzerinden toplanan insan değerlendirmeleri olmasıdır. Bu sayede uygulayıcılar, ödülü maksimize edecek şekilde bir LLM’yi (ön eğitimi ve gözetimli ince ayarı izleyen üçüncü bir adım olarak) daha da ince ayarlayabilir—operant koşullanma ile benzerlik taşıyan bir süreç [ 62 ].
Bu paradigmanın başarısı, yanıtları derecelendirmek için kullanılan yorumcu kalabalığına dayanır. Bu adımın ne kadar maliyetli olabileceği göz önüne alındığında, verilerin düşük gelirli ülkelerin vatandaşları kullanılarak toplanması yaygındır. Psikoterapi durumunda ise mevcut veri setlerinin—ve dolayısıyla modellerin—ruh sağlığı hastaları veya sağlık hizmeti verenler tarafından etiketlenmiş olması son derece olası değildir. Bu durum, hedeflediğimiz senaryo için bu modellerin güvenilirliğini sorgulatır; üstelik bir müdahalenin etkisi (bir LLM yanıtı biçiminde sunulan) doğası gereği oldukça öznel olabilir ve hastalrın kendisinden geri bildirim gerektirir. Bu geri bildirim, zaten ağır bir zihli yük altında olan hastalrın geri bildirim vermesi gereken klinik pratiğe çevrildiğinde zorlu bir süreçtir, ancak LLM’lerin klinik pratikteki güvenilirliğini ve uygulanabilirliğini önemli ölçüde artırabilir. Bu amaçla, hasta gruplarının, LLM’leri kendi ilgi alanlarına daha uygun yanıtlara yönlendirmeye yardımcı olacak geri bildirimlerle katkıda bulunan gönüllüler olarak entegrasyonunu hayal edebiliriz—tıpkı klinik deneylere gönüllü katılımı yönlendiren topluluk çalışmalarına benzer şekilde.
3.3 Üretimin kontrolü
Kontrol edilebilirlik konusunu önceki bölümde zaten ele aldık. Psikoterapinin hassas doğası göz önüne alındığında, bir LLM’nin çıktısı etrafında belirli güvenlik koruyucuları (guardrails) kurmanın bir yolu olmasını istemek doğal bir istektir. Üstelik, ruh sağlığı hastalarını yönetmek için gereken son derece uzmanlaşmış bilgi göz önüne alındığında, başka bir gereksinim de eğitimin ardından modele (yeni) bilgi enjekte edebilme yeteneğidir. Son olarak, psikoterapi görüşmelerinin kişiselleştirilmiş doğası göz önüne alındığında, LLM’nin her çıktıyı üretirken hastanın geçmişini “akında” tutması hayati önem taşır. Bu gereksinimler şu anda sorgulama (prompting) ve onun daha gelişmiş “kız” tekniği olan retrieval augmented generation (RAG) kullanılarak ele alınıyor. Bu teknikler mükemmel uzak olsa da, kontrol edilebilirlik ve bellek sorunlarını kısmen azaltabilir; ancak bunları tamamen ortadan kaldırmak için daha fazla araştırmaya ihtiyaç vardır.
3.3.1 Sorgulama (Prompting)
Prompting, bir LLM’nin girdisini genişleterek, modelin nasıl davranması gerektiğine dair ek bilgi veya talimatlar eklemeyi içeren süreçtir. Bu, yaygın olarak dolaşıma giren; bir LLM’ye “samimi bir ütle yanıt verin” gibi talimatlar veren prompt’larla da görüldüğü gibi, model için bir “ortam hazırlama” işlevi görür. Ayrıca hastaya dair arka plan bilgisini entegre etmek için de kullanılabilir; örneğin, standart değerlendirme ölçekleri sonuçları ve demografik bilgiler kullanılarak (“yakında PHQ-9 ölçeğinde 20 alan genç bir üniversite öğrencisi bu”).
Prompt’lar modele ve bağlama özgülüdür; bu nedenle bir prompt’un başarısı yalnızca gerçek hastalarla yapılan görüşmeleri içeren deneme-yanılma sürecıyla ölçülebilir (her ne kadar önceden bir arama yapılmış olsa bile). Üstelik prompt’lar biçimlendirmeye duyarlıdır ve LLM’lerin doğasının stokastik olmaya devam etmesi—yani aynı girdi verilse bile modelin yine farklı bir çıktı üretmesi—nediğiyle kontrol edilebilirlik sorununu yalnızca kısmen hafifletir [ 63 ]. Bu başarısızlık riski, psikoterapinin hassas doğası bakımından önemli bir endişe taşırken, prompting’den sağlanabilecek potansiyel yararlar da oldukça büyük olabilir; pratikte nasıl kullanılabileceği ise henüz görülecektir.
3.3.2 Geri dönüşümle güçlendirilmiş üretimi (RAG)
Önceki alt bölümde, ek bağlam ekleyen veya çıktıyı kısıtlayan elle hazırlanan prompt’ları tanıtmıştık. Aynı temel mekanizma, otomatik prompt’lar için de kullanılabilir. Bunlar, eğitim sırasında LLM’nin erişemediği yeni bilgileri, geri dönüşümle güçlendirilmiş üretimi (retrieval augmented generation, RAG) adı verilen bir teknikle (veya teknik ailesinin) parçası olarak sisteme dahil eder. RAG, bir sorguyu içeren bilgiyi metinsel belgeler (diğer adıyla varlıklar) veritabanında arayarak çalışır; en basit haliyle bu sorgu, LLM’nin üretimi başlatmadan önceki ilk girdisiidir.
İlginçtir ki, aynı teknik bir LLM’in belleğini yapay olarak güçlendirmek için de kullanılabilir: hasta için ilgili bilgiler (örneğin önceki seanslarda toplananlar) depolanır ve güncel seans sırasında ilgili hale geldiklerinde geri getirilir. Çoğu LLM için bağlam 200.000 tokena kadar ulaşabildiğinden, geçmiş konuşmalardan ilgili parçaları geri getirme yükünün önemli bir kısmı RAG’ye devredilebilir (mevcut seansın uzunluğu bağlam penceresini aşarsa, o seansın içeriğinden bile olsa). Başlıca zorluk, sorgunun önceden bilinmemesi nedeniyle, veritabanına depolanması gereken konuşmanın hangi kısımlarının ilgili olduğunu belirlemektedir; ancak bu kısım dil analizi kullanılarak otomatikleştirilebilir.
3.4 LLM’lerin bağlama yerleştirlmesi
Performansı iyileştirmenin en umut verici yollarından biri, LLM’lerin kapsayıcı bağlama yerleştirmesidir; yani tamamlayıcı bilgi kaynaklarından veri dahil etmek. Bu, elektronik sağlık kayıtları veya giyilebilir algılama ile entegrasyon yoluyla yapılabilir [ 64 ]. Bu tamamlayıcı bilgi kaynakları, LLM etkileşimini (örneğin diyalog desteği veya EMA algılama) hastanın günlük hayatının kapsayıcı bağlamına oturtmaya yardımcı olabilir. Böylece, çok modlu bilgiyi işleme yeteneği, LML’ler için daha bütünleşik bakım noktalarının temel sağlayıcısı haline gelebilir.
3.5 LLM yeteneklerinin değerlendirilmesi
LLM yeteneklerinin bütüncül değerlendirmesi hâlâ açık bir araştırma sorusu olarak kalmaya devam ediyor [ 65 ]. Belirli amaç, değerlendirme kriterlerini belirler: tanısal görevler genellikle özgüllük ve duyarlılık açısından değerlendirilirken, üretken görevler daha ince ayrıntılara dayalı bir yaklaşımla ele alınmayı gerektirir. Üretken yaklaşımlar hem gerçekliği (örneğin bilginin doğruluğu ve geri dönüşü, ayrıca yeni içeriklerin uydurulması) hem de uygunluğu (yanıtın mevcut durumda ne kadar uygun olduğunu) değerlendirmelidir. Bunun ötesinde, dikkate alınması gereken farklı boyutlar da vardır: bozulmalara ve saldırgan saldırılarına dayanıklılık, farklı nüfuslar arasında adalet, sistem güvenliğini delme girişimleri ve konuşlandırma öncesinde performansı nicelendirmeyi amaçlayan diğer çok boyutlu ölçütler.
Uygun LLM ölçütlerinin geliştirilmesi hassas bir işidir: bir yandan, halka açık veri setlerinin kullanılması tekrarlanabilir araştırmanın ön koşuludur; diğer yandan bir veri setinin açıkça yayınlanması, makine öğrenimi alanında “p-hacking”in karşılığı olan ve çözümlerin belirli bir test setine aşırı uyumlandırıldığı yaygın bir “ölçüt hackleme” olgusuna yol açar. Ayrıca, ruh sağlığı ölçütleri hasta gizliliğini korumaya özen göstermelidir—veri setleri kişisel ve kimlik bilgisini içerebileceğinden kolayca yayınlanamaz.
Bu çalışmanın kapsamı dışında kalan değerlendirme için güncel standart uygulamaları belgelemek veya bunların olumsuz yanlarına çözümler önermek yerine, hem ruh sağlığı hem de teknoloji tarafındaki uygulayıcılara değerlendirme protokolüne dikkat etmeleri konusunda uyarıda bulunuyoruz. Bir ölçüt, insan doğasının karmaşık dünyasının yalnızca belirli, dar bir dilimini ölçebilir; belirli bir veri setinde iyi performans elde etmek, bu alt nüfusun ötesinde genelleşme konusunda hiçbir garanti sunmaz.
3.6 Uygulama açısından dikkat edilmesi gerekenler
Araştırma ile klinik pratiği birleştirmek büyük bir çaba gerektirir. LLM’leri halkın ilgi odağı haline getiren ChatGPT’nin yayımlanmasından neredeyse 3 yıl geçti, üretken metin modelleri üstün performans sergilemeye başladığından ise daha uzun bir süre oldu. Buna rağmen bu modellerin klinik ortamlardaki kullanımı hâlâ geride kalmaya devam ediyor. Bu gecikmenin bir bölümü, bir sonraki bölümde özetlenen sınırlamalarından kaynaklanıyor. Bir bölümü ise iç işleyişlerine dair farkındalığın eksikliğinden kaynaklanıyor; bu makale bu açığı kapatmayı amaçlıyor. Bunun yanı sıra, hesaba katılması gereken uygulama biliminden ek hususlar da var.
Başlı engellerinden biri hesaplama karmaşıklıklarıdır. Çıkarım, çoğu klinik ortamda bulunmayan üst düzey grafik işlem birimlerinin (GPU) kullanılmasını gerektirir. Bu da somut entegrasyon çabaları gerektiren ancak aynı zamanda gizlilik risklerini de artıran üçüncü taraf hesaplama platformlarının kullanımını zorunlu kilar. Bu durum, LLM’lerin elektronik tıp kayıtları gibi ek veri biçimleriyle entegrasyon ihtiyacı tarafından daha da kötüleşiyor. Bu, mevcut bilişim altyapısıyla entegrasyon için gerekli çabaları artırırken gizlilik risklerini de daha da artırıyor. Böylece, yerel olarak konuşlandırılabilen ve daha az hesaplama gerektiren modellere geçiş, uygulayıcıların bu konuşlandırma konularını göz önünde bulundurması gereken yükü hafifletecektir.
Bununla birlikte, temel darboğaz hâlâ güvendir: uygulayıcıların, hastaların ve kamu kurumlarının güveni. Mevzuat, LLM’lerin yetenekleriyle başa çıkamamış ve model geliştiricilerinin model performansına ilişkin hesap verebilirliği, dolayısıyla sorumluluğu konusunda birkaç açık soruyu yanıtsız bırakmaktadır. Klinik ortamlardaki hatalar dramatik sonuçlar doğurabilir ve bu modeller yaygın biçimde benimsenmeden önce yasal sorumluluk konusunun çözülmesi gerekmektedir. Üstelik güven, yasal çerçevenin ötesine geçer: Yararlar risklerden fazla mı? Hasta verisi güvende mi? Model güncellemeleri hastaların yararına mı yapılıyor? Bunlar, halk tarafından hakkıyla sorulan sorular arasındadır. Bunları yanıtlamak için özgül bir çaba harcanmalıdır. Önde gelen çoğu LLM’nin özel kuruluşlar tarafından eğitildiği göz önüne alındığında, topluluğun bu modelleri nesnel biçimde değerlendirmenin yollarını düşünmesi gerekir; belki de ilaçlar için yapılan klinik deneylerden ilham alınabilir.
3.6.1 İnsan unsuru
Derinlemesine tartışılmayı hak eden uygulama biliminin belirli bir yönü, LLM’lerin insan iş akışlarına entegrasyonudur. Sonuçta, hayal ettiğimiz araçlar hastalara ve ruh sağlığı uygulayıcılarına yardımcı olmak için tasarlanmıştır.
Her iki durumda da empati, LLM yanıtlarının kritik bir bileşeni haline gelmektedir. Empatiyi simüle etmede başarılı oldukları gösterilmiş olsa da, bu yalnızca kısa yanıtlar için yapılmıştır ve ruh sağlığı bağlamında zaman içinde birden fazla etkileşim alanına aktarılabilir olmak zorunda değildir. Aslında, terapist ile hastadaki terapötik bağ, tek bir LLM yanıtını değerlendirmenle yakalanamayacak kadar çok daha zengin bir kavramdır [ 67 ]; bazıları empatinin dijital eşlerle tamamen sağlanıp sağlanamayacağı konusunda tartışmaktadır bile [ 68 ].
Son olarak, LLM araçlarının klinik iş akışına entegrasyonunun belirli bir derecede klinik gözetim gerektirdiğini belirtiyoruz. Bu da diğer görevlerden (örneğin bakım sağlama, sürekli eğitim) yönlendirilecek insan kaynaklarının kullanılmasını zorunlu kılıyor. Bu nedenle, her yeni aracın getirdiği yararlar, artan yüklenme maliyetiyle dengelenmelidir. Bir uyarıyla bitiriyoruz: Mevcut iş akışlarına teknolojinin entegrasyonunda her şeyi çözen mucizevi çözümler yoktur. Bu durum, teknolojik ilerlemelerle gerçek dünya klinik uygulaması arasındaki boşluğu dolduran uygulama biliminin kapsamına girer.
3.7 Sınırlamalar
LLM’ler önemli bir vaat göstermekle birlikte, aşağıda bir kısmınıcelediğimiz birkaç teknik ve etik sınırlamaya hala sahiptir. Önemlisi, bu araçların klinik uygulamaya aktarılması, güçlü ve zayıf yanlarının kapsamlı ve eleştirel biçimde incelenmesini gerektirir. Bir kez daha, bu; bir yanda bilinen sınırlamaları soruşturan psikologlar, diğer yanda modelleriyle ilgili riskler konusunda şeffaf olan model geliştiriciler arasında köprü kuran bütüncül bir yaklaşımı çağırır.
Halusinasyonlar: LLM’lerin en yaygın biçimde belgelenmiş sınırlamalarından biri, ikna edici ancak gerçek dışı bilgiler üretme eğilimidir [ 69 ], “halusinasyon” olarak bilinen bu olgu. Halusinasyonlar, tüm potansiyel ruh sağlığı uygulamaları için büyük bir risk temsil eder: zararlı öneriler üretmekten, eğitim seansları sırasında terapötik teknikleri yanlış sunmak ya da tutarsız notlar oluşturmak; hallucinations yaygın bir sorundur. Üstelik, hallusinasyonlar LLM paradigmasının özünde yer alır ve dolayısıyla tamamen ortadan kaldırılamaz [ 70 ]. Bu, yalnızca LLM’lerin kullanımına, özellikle terapi desteği gibi yüksek riskli uygulamalarda sıkı bir insan gözetimiyle aşılabilen temel bir sınırlamadır. Bu ilke, ruh sağlığı uzmanlarının LLM yanıtlarını doğrulamalarını istemek ya da en azından zaman içinde bunları izlemek suretiyle hayata geçirilebilir. Bu konuyu aşağıda tartışıyoruz.
Yanlışlık değerlendirmesi: YYModelleri varolan önyargıları güçlendirebilir; bu da düşük kaliteli veya zararlı yanıtlara [ 71 ] ve gruplar arası farklı muamele önerilerine [ 72 ] yol açar. Önyargı azaltma teknikleri [ 73 ] mevcut olsa da, klinik yararlılığa zarar verecek şekilde aşırı düzeltme yapılmamalıdır (örneğin modeller adil olmalı ve gruplar arası gerçek psikopatolojik farklılıklara yanıt vermeye devam etmelidir). Bu, YYModellerini hâlâ etkileyen ve kısmen eğitim verilerine yerleşmiş önyargılardan kaynaklanan bir sorundur. Çoğu model geliştirici, modellerinin gösterdiği önyargıları belgelemek için model kartları [ 74 ] kullansa da, bu tüm modeller için zorunlu değildir ve değerlendirmeler önyargının tüm olası kaynaklarını kapsamaz. Ruh sağlığı uzmanlarının, aday bir modelin hedef uygulama senaryosu ve hasta alt-popülasyonu için değerlendirilip değerlendirilmediğini eleştirel biçimde düşünmesi ve aktif biçimde sorması önerilir. En iyi durumda, dağıtım öncesinde kendi kullanım senaryoları için YYModeli yanıtlarının geçerliliğini test ederler; örneğin değerlendirme için özel bir test kümesi kullanırlar.
Gizlilik: YYModelleri eğitim verilerinden bilgi ezberleyebilir ve istemsiz biçimde ifşa edebilir [ 75 ]. Ayrıca, hangi bilginin hangi bağlamlarda paylaşılabileceği konusunda akıl yürütmekte zorlanırlar [ 76 ]; bu da gizliliği zedeleyebilir. Bu riskler, YYModellerini iş akışlarına ve belgeleme sistemlerine entegre ederken, özellikle modellerine bulut üzerinden erişim sağlayan dış model sağlayıcılarına güvendikte, sıkı veri koruma önlemlerini zorunlu kılar. Bulut tabanlı hizmetlerin, istemci verileri üzerinde sonraki model eğitimine izin verdiği bilinmektedir; uzmanlar hizmet şartlarını dikkatlice gözden geçirmeli ve istemci verileri üzerinde model iznini sağlayan model sağlayıcılarından kaçınmalıdır.
Sözleşmecilik (Sycophancy): İnsan geri bildirmesiyle eğitilen LLM’ler, yanıtın doğruluğundan kullanıcı uyumunu önceliklendirebilir [ 77 ]. Bu, modelin terapötik yüzleşmeden kaçınması veya yıkıcı davranışları uygunsuz biçimde onaylaması biçiminde ortaya çıkabilir. Bu davranış, otomatik tanı görüşmeleri veya terapi desteği sunan sohbet robotları gibi hastayla doğrudan etkileşim kuran uygulamalarda özellikle zararlı olabilir. Önemlisi, teknolojinin hassas kullanıcılarında manipülasyon veya artan duygusal bağımlılığa da yol açabilir. Ruh sağlığı uzmanları, hastaları için LLM kullanımı önerirken bu olumsuz etkileri proaktif biçimde izlemelidir; örneğin hastalarla düzenli görüşme veya uygun ölçeklerin uygulanması yoluyla.
Güvenlik LLM’ler zararlı içerik üretebilir veya kullanıcı aşırı bağımlılığını teşvik edebilir [ 78 ]. Disteste uygun yanıt veremeyebilir [ 79 ] ve gerektiğinde durumları profesyonel insanlara aktaramayabilir [ 80 ]. Bu riskler, sistemlerin sıkı güvence ve insani gözetim ile müdahale için açık yollar içerecek biçimde tasarlanmasının gerekliliğini vurgular. Kritik olan, LLM’lerin bir mucizevi çözüm olarak görülmemesi, bunun yerine bu güncelleri hayata geçiren mevcut klinik iş akışlarının bir parçası olarak entegre edilmesi gerektiğidir. Örneğin, intihar düşüncesi daha geleneksel yöntemlerle (ölçekler, görüşmeler) tespit edilebilir ve kullanıcının daha önce geçirdiği LLM görüşmelerinin daha kapsamlı biçimde gözden geçirilmesini tetikleyebilir.
Bu sınırlamaları anlamak kritik öneme sahiptir: Psikologlar araçları değerlendirmeli ve bilinçli geri bildirim sağlamalı; geliştiriciler ise tam çözümlerin henüz mümkün olmadığı durumlarda bile sistemlerinin amaçlanan kullanımını, eksikliklerini ve yönetim stratejilerini iletişime geçmelidir. Paylaşılan bu anlayış, psikoteride sorumlu ve etkili LLM uygulamasının temelini oluşturur.
4 Sonuç
Yapay zekâ modellerinin (LLM) konuşma motorları olarak dünyayı fetheden olağanüstü başarısını sağlayan yapı taşları, eğitim yöntemleri ve kullanım tekniklerinin nasıl bir araya geldiğine dair özet, kolayca sindirilebilir bir genel bakış sunduk. Özetle, LLM’ler dilin rastlantısal, kendine özgü (autoregressive) modelleridir; bir metin girdisi ya da istemi verildiğinde, girdinin iyi bir devamı niteliğinde bir metin çıktısı üretirler. Bu çıktı her seferinde benzersizdir ve tek tek belirteçler (token) halinde üretilir. Üretim süreci, eğitim sırasında veriden öğrenilen örüntüleri kullanır ve tutarlı yanıtlar üretmek için girdi bağlamını hesaba katar. Böylece, psikologların klinik uygulamasıyla ilgili not özetlemekten otonom psikoterapi seansları yürütmeye kadar çok sayıda işlevi desteklemek için kullanılabilir. Tedaviye yönelik güncel engeller göz önüne alındığında, bu teknolojinin ruh sağlığı bozukluklarının daha iyi sunulmasında kilit bir rol oynamasını bekliyoruz. Kritik önem taşıyan şu ki, bu modellerin sorumlu şekilde geliştirilmesi ve klinik uygulamaya taşınması, ruh sağlığı ve teknik topluluklar arasında daha yakın bir işbirliğini gerektiriyor. Bu genel bakışın, psikoloji topluluğunun LLM’lerin gelecekteki gelişimine daha fazla katılmasına ve iki topluluk arasında daha sıkı bir gelecekteki işbirliğine yol açmasını umuyoruz.
Birçok gelecek araştırma yönü göz önünde bulundurulmaya değer: LLM’lerin yeteneklerinin sürekli değerlendirmesi, diğer tıp alanlarında giderek daha sık uygulanan bir yöntem olan “kırmızı takım” (red-teaming) çalışması [ 81 ]; eğitim ve değerlendirmede yeterliliği temsil edilen demografik grupların kapsamaya yönelik çaba; müdahalelerin etkinliğini değerlendiren titiz klinik deneylerin gerekliliği; hastaların gizlilik hakkına saygı gösteren, açık kaynaklı ve tekrarlanabilir kıyaslama setlerinin oluşturulması; etkileşimler sırasında veri gizliliğinin güvence altına alınması hem de LLM’lerden kaynaklanan hatalar ve uydurumların yarattığı tehlikeler açısından sıkı güvenlik gereksinimleri; LLM’lerin etkinliğinin kanıtlandıktan sonra, pratikteki benimsenmesine engel olan kurumsal engellerin belirlenmesi ve bu darboğazların ortak tasarım ilkesiyle giderilmesi zorunluluğu. Bunlar, LLM’lerin vaatlerini gerçekleştirmesinden önce kat edilmesi gereken birçok gelecek araştırma yolun yalnızca bir kısmıdır.
Açıklamalar
Yazar katkıları
AT: Yazma – inceleme & düzenleme, Yazma – özgün taslak, Kavramsal. YT: Yazma – inceleme & düzenleme, Yazma – özgün taslak. IT: Yazma – özgün taslak, Yazma – inceleme & düzenleme. FP: Yazma – inceleme & düzenleme. KB-P: Yazma – inceleme & düzenleme. LS: Yazma – inceleme & düzenleme. AK: Yazma – inceleme & düzenleme. JC: Yazma – inceleme & düzenleme. DA-S: Yazma – inceleme & düzenleme. ML: Yazma – inceleme & düzenleme. MB: Yazma – inceleme & düzenleme. JL: Yazma – inceleme & düzenleme, Kavramsal. BS: Yazma – inceleme & düzenleme, Kavramsal.
Finansman
Yazar(lar), bu çalışma ve/veya yayını için herhangi bir finansal destek alınmadığını beyan etmiştir.
Tesekkürler
Bu makale, Triantafyllopoulos ve ark. 2024 adıyla arXiv’e ön yazı (preprint) olarak sunulmuştur.
Çıkar çatışması
Yazar(lar), bu çalışmanın, olası bir çıkar çatışması olarak değerlendirilebilecek herhangi bir ticari veya finansal ilişki içinde yürütülmediğini beyan etmiştir.
Üretken yapay zekâ açıklaması
Yazar(lar), bu makalenin oluşturulmasında Üretici Yapay Zekânın kullanılmadığını beyan etmiştir.
Bu makaledeki şekillerle birlikte sağlanan alternatif metinler (alt text) Frontiers tarafından yapay zekânın desteğiyle oluşturulmuş olup, mümkün olduğunca yazarların incelemesini de içeren makul çabalarla doğruluğunun sağlanmasına effort edilmiştir. Herhangi bir sorunu tespit ederseniz, lütfen bizimle iletişime geçin.
Yayıncının notu
Bu makalede ifade edilen tüm iddialar yalnızca yazarların görüşlerini yansıtır ve bağlı oldukları kuruluşların, yayıncının, editörlerin veya hakemlerin görüşlerini mutlaka temsil etmez. Bu makalede değerlendirilebilecek herhangi bir ürün veya üreticisinin yapabileceği herhangi bir iddia, yayıncı tarafından garanti edilmez veya desteklenmez.
Dipnotlar
1.^https://woebothealth.com/.
2.^Tokeniser’iniz için burada deneme yapabilirsiniz: https://belladoreai.github.io/llama3-tokenizer-js/example-demo/build/ ve https://platform.openai.com/tokenizer.
-
1.
World Health Organization. World mental health report: transforming mental health for all. Tech. rep., Geneva (2022).
- Makalede referansı gör
-
2.
HerrmanHPatelVKielingCBerkMBuchweitzCCuijpersP, et al. Time for united action on depression: a Lancet–World Psychiatric Association Commission. Lancet. (2022) 399:957–1022. 10.1016/S0140-6736(21)02141-3
- Pubmed Özeti
- CrossRef
- Google Scholar
- Makalede referansı gör
-
3.
JamesSLAbateDAbateKHAbaySMAbbafatiCAbbasiN, et al. Global, regional, and national incidence, prevalence, and years lived with disability for 354 diseases and injuries for 195 countries and territories, 1990–2017: a systematic analysis for the Global Burden of Disease Study 2017. Lancet. (2018) 392:1789–858. 10.1016/S0140-6736(18)32279-7
- Pubmed Özeti
- CrossRef
- Google Scholar
- Makalede referansı gör
-
4.
Terhorst,Y., Kaiser,T., Brakemeier,E.-L., Moshe,I., Philippi,P., Cuijpers,P., et al. Tedavi etkilerindeki heterojenilik: internet ve mobil tabanlı depresyon müdahaleleri. JAMA Netw Open. (2024) 7:e2423241. 10.1001/jamanetworkopen.2024.23241
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
5.
Moshe,I., Terhorst,Y., Philippi,P., Domhardt,M., Cuijpers,P., Cristea,I., et al. Depresyonun tedavisinde dijital müdahaleler: meta-analiz temelli bir derleme. Psychol Bull. (2021) 147:749–86. 10.1037/bul0000334
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
6.
Seiferth,C., Vogel,L., Aas,B., Brandhorst,I., Carlbring,P., Conzelmann,A., et al. E-mental health nasıl yapılır: ruh sağlığı bağlamında dijital teknoloji kullanan araştırmacılar ve uygulayıcılar için bir yol haritası. Nat Ment Health. (2023) 1:542–54. 10.1038/s44220-023-00085-1
- CrossRef
- Google Scholar
- View reference in article
-
7.
Buck,B., Kadakia,A., Larsen,A., Tauscher,J., Guler,J., Ben-Zeev,D. Ruh sağlığı hizmetleri için bekleme listesindeki kişiler için dijital müdahaleler: bir ihtiyaç değerlendirmesi ve tercih anketi. Pract Innov. (2024) 10(1):32–42. 10.1037/pri0000250
- CrossRef
- Google Scholar
- View reference in article
-
8.
Chang,H.-Y., Park,E.-J., Yoo,H.-J., Lee,J.-W., Shin,Y. Erken çocukluk döneminde elektronik medya maruz kalması ve kullanımı. Psychiatry Investig. (2018) 15:568. 10.30773/pi.2017.11.30.2
- Pubmed Abstract
- CrossRef
- Google Scholar
-
9.
Hedman-Lagerlöf,E., Carlbring,P., Svärdman,F., Riper,H., Cuijpers,P., Andersson,G. Terapist desteği sunulan internet tabanlı bilişsel davranışçı terapi, psiyatrik ve somatik bozukluklarda yüz yüze terapyle benzer etkiler sunar: güncellenmiş sistematik derleme ve meta-analiz. World Psychiatry. (2023) 22:305–14. 10.1002/wps.21088
- CrossRef
- Google Scholar
- View reference in article
-
10.
Cuijpers P, Nomа H, Karyotaki E, Cipriani A, Furukawa T A. Etkinlik ve kabul edilebilirlik açısından bilişsel davranışçı terapi sunum biçimleri: depresyonlu yetişkinlerde ağ meta-analizi. JAMA Psychiatry. (2019) 76:700–7. 10.1001/jamapsychiatry.2019.0268
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
11.
Philippi P, Baumeister H, Polinário-Hagen J, Ebert D D, Hennemann S, Kott L, ve diğerleri. Dijital sağlık müdahalelerine yönelik kabul: teknolojinin kabulü ve kullanımı için birleşik teorinin geçerliliğinin sağlanması ve geliştirilmesi. Internet Interv. (2021) 26:100459. 10.1016/j.invent.2021.100459
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
12.
Moshe I, Terhorst Y, Philippi P, Domhardt M, Cuijpers P, Cristea I, ve diğerleri. Depresyonun tedavisinde dijital müdahaleler: meta-analitik bir derleme. Psychol Bull. (2021) 147:749. 10.1037/bul0000334
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
13.
Baumel A, Edan S, Kane J M. Yönlendirilmeyen e-mental sağlık müdahalelerine kullanıcı katılımını etkileyen bir deney yanlılığı var mı? Aynı programların yayımlanan raporları ile gerçek dünya kullanımının sistematik karşılaştırması. Transl Behav Med. (2019) 9:1020–33. 10.1093/tbm/ibz147
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
14.
Vaidyam A N, Linggonegoro D, Torous J. Psikiatrik chatbot manzarasındaki değişimler: ciddi mental hastalikte konuşma ajanlarının sistematik derlemesi. Can J Psychiatry. (2021) 66:339–48. 10.1177/0706743720966429
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
15.
Abd-Alrazaq A, Alajlani M, Alalwan A A, Bewick B, Gardner P, Househ M. Sohbet robotlarının ruh sağlığındaki özelliklerine bir genel bakış: bir tarama derlemesi. Int J Med Inform. (2019) 132:103978. 10.1016/j.ijmedinf.2019.103978
- Pubmed Abstract
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
16.
Demszky D, Yang D, Yeager D S, Bryan C J, Clapper M, Chandhok S, et al. Psikolojide büyük dil modellerinin kullanımı. Nat Rev Psychol. (2023) 2:688–701. 10.1038/s44159-023-00241-5
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
17.
Weizenbaum J. ELIZA—insan ile makine arasındaki doğal dil iletişiminin çalışılması için bir bilgisayar programı. Commun ACM. (1966) 9:36–45. 10.1145/365153.365168
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
18.
Li H, Zhang R, Lee Y C, Kraut R, Mohr D C. Ruh sağlığını ve iyi oluşu teşvik eden yapay zekâ tabanlı konuşma ajanlarının sistematik derlemesi ve meta-analizi. npj Digit Med. (2023) 6:236. 10.1038/s41746-023-00979-5.
- Pubmed Abstract
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
19.
He Y, Yang L, Qian C, Li T, Su Z, Zhang Q, et al. Ruh sağlığı sorunları için konuşma ajanı müdahaleleri: rastgele kontrollü çalışmaların sistematik derlemesi ve meta-analizi. J Med Internet Res. (2023) 25:e43862. 10.2196/43862
- Pubmed Abstract
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
20.
Bendig E, Erb B, Schulze-Thuesing L, Baumeister H. Bir sonraki nesil: klinik psikoloji ve psikoterapide ruh sağlığını destekleyen sohbet robotları—bir tarama derlemesi. Verhaltenstherapie. (2022) 32:64–76. 10.1159/000501812
- CrossRef
- Google Scholar
- Makaledeki referansı görüntüle
-
21.
Stade E, Cirman S, Ungar L H, Boland C L, Schwartz H A, Yaden D B, et al. Dil modellerinin davranışsal sağlık hizmetlerinin geleceğini değiştirmesi mümkün: Sorumlu geliştirme ve değerlendirme için bir öneri. npj Mental Health Res. (2024) 3:12. 10.1038/s44184-024-00056-z
- CrossRef
- Google Scholar
- Referansı makalede görüntüle
-
22.
Daele T V, Mathiasen K, Carlbring P, Bernaerts S, Brugnera A, Compare A, et al. Ruh sağlığı hizmetlerinde online görüşmeler: Pandemi başlangıcında uluslararası bir anket çalışmasına dayalı kullanım ve deneyimin belirleyicilerinin modellenmesi. Internet Interv. (2022) 30:100571. 10.1016/j.invent.2022.100571
- Pubmed Abstract
- CrossRef
- Google Scholar
- Referansı makalede görüntüle
-
23.
Monteith S, Glenn T G, Geddes J, Whybrow P C, Achtyes E, Bauer M. Psikiyatride yapay zeka (AI) beklentileri. Curr Psychiatry Rep. (2022) 24:709–21. 10.1007/s11920-022-01378-5
- Pubmed Abstract
- CrossRef
- Google Scholar
- Referansı makalede görüntüle
-
24.
Bommasani R, Hudson D A, Adeli E, Altman R, Arora S, von Arx S, et al. Temel modellerin sunduğu fırsatlar ve riskler hakkındak. arXiv [Ön baskı]. arXiv:2108.07258 (2021).
- Google Scholar
- Referansı makalede görüntüle
-
25.
Guo Z, Lai A, Thygesen J H, Farrington J, Keen T, Li K. Ruh sağlığı uygulamaları için büyük dil modelleri: Sistematik derleme. JMIR Ment Health. (2024) 11:e57400. 10.2196/57400
- Pubmed Abstract
- CrossRef
- Google Scholar
- Referansı makalede görüntüle
-
26.
Xian X, Chang A, Xiang Y-T, Liu M T. Ruh sağlığı bakımında üretken yapay zeka konusunda tartışmalar ve ikilemler: Kapsam taraması derleme. Interact J Med Res. (2024) 13:e53672. 10.2196/53672
- Pubmed Abstract
- CrossRef
- Google Scholar
- Referansı makalede görüntüle
-
27.
HuaYNaHLiZLiuFFangXCliftonD, et al. Dil modellerinin ruh sağlığı bakımında üretici görevlere kullanımına dair kapsamlı bir derleme. npj Digit Med. (2025) 8:230. 10.1038/s41746-025-01611-4
- Pubmed Abstract
- CrossRef
- Google Scholar
-
28.
HuaYLiuFYangKLiZNaHSheuY-h, et al. Ruh sağlığı bakımında dil modelleri: kapsamlı bir derleme. Curr Treat Options Psychiatry. (2025) 12:27. 10.1007/s40501-025-00363-y
- CrossRef
- Google Scholar
-
29.
StadeECStirmanSWUngarLHBolandCLSchwartzHAYadenDB, et al. Dil modelleri davranışsal sağlık bakımının geleceğini değiştirebilir: sorumlu geliştirme ve değerlendirme için bir öneri. npj Ment Health Res. (2024) 3:12. 10.1038/s44184-024-00056-z
- Pubmed Abstract
- CrossRef
- Google Scholar
- View reference in article
-
30.
LawrenceHRSchneiderRARubinSBMatarićMJMcDuffDJBellMJ. Dil modellerinin ruh sağlığındaki fırsatları ve riskleri. JMIR Ment Health. (2024) 11:e59479. 10.2196/59479
- Pubmed Abstract
- CrossRef
- Google Scholar
-
31.
YuLGeYAnsariSImranMAhmadW. Çoklu algılama ile desteklenen dil modelleri ile otomatik duygusal düzenleme: güncel teknolojilerin, fırsatların ve zorlukların derlemesi. Sensors. (2025) 25:4763. 10.3390/s25154763
- Pubmed Abstract
- CrossRef
- Google Scholar
-
32.
KrishnaKKhoslaSBighamJPLiptonZC. Modüler özetleme teknikleri kullanarak hekim-hasta görüşmelerinden soap notları üretme. In: Proceedings of the 59th annual meeting of the association for computational linguistics and the 11th international joint conference on natural language processing (volume 1: long papers) (2021), p. 4958–72.
- Google Scholar
-
33.
Qiu H L, Zang Z. Etkileşimli ajanlar: Rol yapma yoluyla danışman-müşteri psikolo danışmanlığının LLM-LLM etkileşimleri ile simülasyonu. arXiv [Baskı Önü]. arXiv:2408.15787 (2024).
- Google Scholar
-
34.
Chaszczewicz A, Shah R, Louie R, Arnow B, Kraut R, Yang D. Yeni başlayan akran danışmanlarına güç veren büyük dil modelleri ile çok seviyeli geri bildirim üretimi. In: Ku L W, Martins A, Srikumar V, editörler. Hesaplamalı Dilbilimi Derneği’nin 62. Yıllık Toplantısı Bildirileri (Cilt 1: Uzun Bildiriler) (Bangkok, Tayland: Hesaplamalı Dilbilimi Derneği) (2024). s. 4130–61. 10.18653/v1/2024.acl-long.227
- CrossRef
- Google Scholar
-
35.
Meyerhoff J, Beltzer M, Popowski S, Karr C J, Nguyen T, Williams J J, ve ark. Zaman içinde küçük adımlar: Depresyon ve kaygı belirtilerinin kendi kendine yönetimini desteklemek için otomatik etkileşimli mesajlaşma müdahalesinin uzun süreli kullanılabilirlik testi. J Affect Disord. (2024) 345:122–30. 10.1016/j.jad.2023.10.119
- Pubmed Abstract
- CrossRef
- Google Scholar
-
36.
Sharma A, Rushton K, Lin I, Nguyen T, Althoff T. İnsan-dil modeli etkileşimi yoluyla kendi kendine yönlendirilen mental sağlık müdahalelerinin kolaylaştırılması: Bilişsel yeniden yapılandırma üzerine bir olgu çalışması. In: 2024 CHI Hesaplamalı Sistemlerde İnsan Faktleri Konferansı, CHI ’24 (New York, NY, ABD: Hesaplamalı Sistemler için Bilgisayar Derneği) (2024). 10.1145/3613904.3642761
- CrossRef
- Google Scholar
-
37.
Schueller S M, Neary M, Lai J, Epstein D A. İnsanların ruh hali takibi uygulamalarını kullanımı ve bunlara dair görüşlerinin anlaşılması: Röportaj çalışması. JMIR Ment Health. (2021) 8:e29368. 10.2196/29368
- Pubmed Abstract
- CrossRef
- Google Scholar
-
38.
Kim TB, Kim H, Lee S, Hong H, Yang C, et al. Mindfuldiary: büyük dil modellerinden psiyatrik hastaların günlük tutmalarını desteklemek için yararlanmak. In: 2024 CHI İnsan Faktörleri Hesaplama Sistemleri Konferansı Bildirileri, CHI ’24 (New York, NY, ABD: Association for Computing Machinery) (2024). 10.1145/3613904.3642937
- CrossRef
- Google Scholar
-
39.
Seizer L, Schiepek G, Cornelissen G, Löchner J. Ambulatör değerlendirmelerin örneklem hızları üzerine bir rehber. Psychol Methods. (2024). 10.1037/met0000656
- Pubmed Abstract
- CrossRef
- Google Scholar
-
40.
Na H, Hua Y, Wang Z, Shen T, Yu B, Wang L, et al. Psikoterapide büyük dil modelleri üzerine bir araştırma: güncel durum ve geleceğe yönelik yönler. In: Computational Linguistics Derneği Bulguları: ACL 2025 (2025), s. 7362–76.
- Google Scholar
-
41.
Liu N, Lin K, Hewitt J, Paranjape A, Bevilacqua M, Petroni F, et al. Ortada kaybolmak: dil modelleri uzun bağlamları nasıl kullanır. Trans Assoc Comput Linguist. (2024) 12:157–73. 10.1162/tacl_a_00638
- CrossRef
- Google Scholar
-
42.
Heinz MV, Mackin D, Trudeau B, Bhattacharya S, Wang Y, Banta HA, et al. Therabot’u değerlendirmek: depresyon, kaygı ve yeme bozukluğu belirtilerinin tedavisinde üretken yapay zeka terapi sohbet robotunun uygulanabilirliği ve etkinliğini araştıran rastlantısal kontrollü bir deney (2024). Çevrimiçi erişim: https://osf.io/preprints/psyarxiv/pjqmr_v1
- Google Scholar
-
43.
Janota B, Janota K. Yapay zekanın (AI) psiyatrik kliniklerde taburculuk özetlerinin oluşturulmasında kullanımı. Int J Psychiatry Med. (2025) 60:330–7. 10.1177/00912174241284730
- Pubmed Abstract
- CrossRef
- Google Scholar
-
44.
BouguettayaA, TeamV, StuartE, AboujaoudeE. Zeka destekli rapor üretim araçları ruh sağlığı bakımında: ticari araçların incelenmesi. Gen Hosp Psychiatry. (2025) 94:150–8. 10.1016/j.genhosppsych.2025.02.018
- Pubmed Abstract
- CrossRef
- Google Scholar
-
45.
McCruddenKE, SwirbulMS, PeakeEE, RodioMJ, PadmanabhanA. Ruh sağlığı sağlayıcıları için zeka destekli belgeleme: geriye dönük gözlemsik karma yöntem çalışması. JMIR Form Res. (2026) 10:e84628. 10.2196/84628
- Pubmed Abstract
- CrossRef
- Google Scholar
-
46.
LutzW, DeisenhoferA, RubelJ, BennemannB, GiesemannJ, PosterK, ve ark. Psikoterapide klinik karar destek sisteminin ileriye dönük değerlendirmesi. J Consult Clin Psychol. (2022) 90:90. 10.1037/ccp0000642
- Pubmed Abstract
- CrossRef
- Google Scholar
-
47.
ZhangTT, SaundersR, PillingS, O’DriscollC. Bilişsel davranışçı terapistlerin yetkinliklere göre eğitilmesi için zeka destekli hastan platformu (CBT eğiticisi): karma yöntem pilot çalışması. JMIR Med Educ. (2026) 12:e84091. 10.2196/84091
- Pubmed Abstract
- CrossRef
- Google Scholar
-
48.
SelimR, BasuA, AntoA, FoschtE, EisingerichAB. Büyük dil modellerine dayalı hizmetlerin öğrencilerin refahı üzerindeki etkileri: niteliksel çalışma. JMIR Form Res. (2024) 8:e64081. 10.2196/64081
- Pubmed Abstract
- CrossRef
- Google Scholar
-
49.
JeanS, ChoK, MemisevicR, BengioY. Çok büyük hedef sözcük dağarcığının sinirsel makine çevirisinde kullanımı. In: 53. yıllık hesaplama dilbilgisi toplantısı ve doğal dil işleme konusunda 7. uluslararası ortak konferans (cilt 1: uzun makaleler) (2015), sayfa 1–10.
- Google Scholar
-
50.
Dubey A, Aauhri A, Pandey A, Kadian A, Al-Dahle A, Letman A, et al. The llama 3 herd of models. arXiv [Baskı Öncesi]. arXiv:2407.21783 (2024).
- Google Scholar
-
51.
Sennrich R, Haddow B, Birch A. Neural machine translation of rare words with subword units. In: Proceedings of the 54th annual meeting of the association for computational linguistics (2016).
- Google Scholar
-
52.
Pennington J, Socher R, Manning C. Global vectors for word representation. In: Proceedings of the 2014 conference on empirical methods in natural language processing (EMNLP) (2014), s. 1532–43.
- Google Scholar
-
53.
Mikolov T, Tutskever I, Chen K, Corrado G, Dean J. Distributed representations of words and phrases and their compositionality. Adv Neural Inf Process Syst. (2013) 26. 10.48550/arXiv.1310.4546
- CrossRef
- Google Scholar
-
54.
Vijayakumar A, Cogswell M, Selvaraju R, Sun Q, Lee S, Crandall D, et al. “Diverse beam search for improved description of complex scenes.” In: Proceedings of the AAAI Conference on Artificial Intelligence (2018) Vol. 32, No. 1.
- Google Scholar
-
55.
Bender E, Koller A. Climbing towards NLU: on meaning, form, and understanding in the age of data. In: Proceedings of the 58th annual meeting of the association for computational linguistics (2020), s. 5185–98.
- Google Scholar
-
56.
Vaswani A, Shazeer N, Marar N, Uszkoreit J, Jones L, Gomez A, et al. Attention is all you need. Adv Neural Inf Process Syst. (2017) 30. 10.48550/arXiv.1706.03762
- CrossRef
- Google Scholar
-
57.
Boyd R, Ashokkumar A, Seraj S, Pennebaker J. The Development and Psychometric Properties of LIWC-22. Austin, TX: University of Texas At Austin (2022). 10.
- Google Scholar
-
58.
Elhage, N. ve diğerleri. Transformer devreleri için matematiksel bir çerçeve. Beyanname. (2021) 1:12.
- Google Scholar
-
59.
Hu, E. J. ve diğerleri. LoRA: Büyük dil modellerinin düşük ranklı uyarlaması. In: Uzmanlık temsilleri uluslararası konferansı bildirileri (2021).
- Google Scholar
-
60.
Dong, Q. ve diğerleri. Bağlam içi öğrenme üzerine bir araştırma. arXiv [Ön Baskı]. arXiv:2301.00234 (2022).
- Google Scholar
-
61.
Bai, Y. ve diğerleri. İnsan geri bildirimiyle pekiştirmeli öğrenme ile yardımcı ve zararsız bir asistan eğitmek. arXiv [Ön Baskı]. arXiv:2204.05862 (2022).
- Google Scholar
-
62.
Staddon, J. E. R. ve Cerutti, D. T. Etken koşullanma. Annu Rev Psychol. (2003) 54:115–44. 10.1146/annurev.psych.54.101601.145124
- Pubmed Abstract
- CrossRef
- Google Scholar
-
63.
Sclar, M. ve diğerleri. Dil modellerinin tasarım ipuçlarındaki sahte özelliklere duyarlılığını nicelendirme veya: ipucu biçimlendirmesinden endişe etmeyi nasıl öğrendim. In: Uzmanlık temsilleri uluslararası konferansı bildirileri (2024).
- Google Scholar
-
64.
Chen, Y. ve diğerleri. Kişiselleştirilmiş mental sağlık diyaloğu için giyilebilir fizyolojik algılama ve geri dönüşümle zenginleştirilmiş büyük dil modelleri: HRV temelli konuşma desteğinin bir kavram kanıtı araştırması. J AI Healthc Biomed Eng. (2025) 3(2):1–27. 10.63646/MWMX5680
- CrossRef
- Google Scholar
-
65.
Arnaout, H. ve diğerleri. Mental sağlık için yapay zeka sorumlu değerlendirmesi. arXiv [Ön Baskı]. arXiv:2602.00065 (2026).
- Google Scholar
-
66.
Sorin V, Brin D, Barash Y, Konen E, Charney A, Nadkarni G, et al. Dil modelleri ve empati: sistematik derleme. J Med Internet Res. (2024) 26:e52597. 10.2196/52597
- Pubmed Abstract
- CrossRef
- Google Scholar
-
67.
Saunders S M, Howard K I, Orlinsky D E. Terapötik bağ ölçekleri: psikometrik özellikler ve tedavi etkinliği ile ilişkileri. Psychol Assess: J Consult Clin Psychol. (1989) 1:323. 10.1037/1040-3590.1.4.323
- CrossRef
- Google Scholar
-
68.
Turkle S. Dijital eşler çağında özgünlük. Interact Stud. (2007) 8:501–17. 10.1075/is.8.3.11tur
- CrossRef
- Google Scholar
-
69.
Huang L, Yu W, Ma W, Zhong W, Feng Z, Wang H, et al. Dil modellerindeki halüsinasyonlara dair bir derleme: ilkeler, sınıflandırma, zorluklar ve açık sorular. arXiv [Ön baskı]. arXiv:abs/2311.05232 (2023).
- Google Scholar
-
70.
Kalai A, Nachum O, Vempala S S, Zhang E. Dil modelleri neden halüsinasyon üretir. arXiv [Ön baskı]. arXiv:2509.04664 (2025).
- Google Scholar
-
71.
Gabriel S, Puri I, Xu X, Malgaroli M, Ghassemi M. Veriler: Yapay zeka ilişki kurabiliyor mu: dil modellerinin ruh sağlığı desteğine yönelik yanıtlarının sınanması (2024).
- Google Scholar
-
72.
Omiye J A, Lester J C, Spichak S, Rotemberg V, Daneshjou R. Dil modelleri ırka dayalı tıbbı yayıyor. npj Digit Med. (2023) 6:195. 10.1038/s41746-023-00939-z
- Pubmed Abstract
- CrossRef
- Google Scholar
-
73.
Gallegos I O, Rossi R A, Arrow J, Tanjim M M, Kim S, Dernoncourt F, et al. Dil modellerinde yanlılık ve adalet: bir derleme. Comput Linguist. (2024) 50(3):1097–179. 10.1162/coli_a_00524
- CrossRef
- Google Scholar
-
74.
Mitchell M, Wu S, Zaldivar A, Barnes P, Vasserman L, Hutchinson B, et al. Model cards for model reporting. In: Proceedings of the conference on fairness, accountability, and transparency (2019), p. 220–9.
- Google Scholar
-
75.
Carlini N, Liu C, Song D. The secret sharer: evaluating and testing unintended memorization in neural networks. In: 28th USENIX security symposium (USENIX security 19) (2019), p. 267–84.
- Google Scholar
-
76.
Mireshghallah N, Kim H, Zhou X, Tsvetkov Y, Sap M, Shokri R, et al. Can LLMs keep a secret? Testing privacy implications of language models via contextual integrity theory. In: The twelfth international conference on learning representations (2024).
- Google Scholar
-
77.
Sharma M, Tong M, Korbak T, Duvenaud D, Askell A, Bowman S R, et al. Towards understanding sycophancy in language models. In: The twelfth international conference on learning representations (2024).
- Google Scholar
-
78.
Ma Z, Mei Y, Su Z. Understanding the benefits and challenges of using large language model-based conversational agents for mental well-being support. In: AMIA annual symposium proceedings (American Medical Informatics Association) (2023), 2023, p. 1105.
- Google Scholar
-
79.
Heston T F. Safety of large language models in addressing depression. Cureus. (2023) 15:e50729.
- Pubmed Abstract
- Google Scholar
-
80.
De Freitas J, Uğuralp A K, Uğuz-Uğuralp Z, Puntoni S. Chatbots and mental health: insights into the safety of generative AI. J Consum Psychol. (2024) 34:481–91. 10.1002/jcpy.1393
- CrossRef
- Google Scholar
-
81.
Pan J, Jian B, Hager P, Zhang Y, Liu C, Jungmann F, et al. Addressing benchmarking gaps in large language models for health and medicine with dynamic red-teaming. Nat Health. (2026).
- Pubmed Abstract
- Google Scholar
-
82.
Triantafyllopoulos A, Terhorst Y, Tsangko I, Pokorny F, Bartl-Pokorny K, Seizer L, ve diğerleri. Large language models for mental health. arXiv [Baskı Önizlemesi]. (2024) Erişim adresi: https://arxiv.org/abs/2411.11880 (Erişim tarihi: 15 Eylül 2026).
- Google Scholar
Sözlük: LLM eğitimi tartışılırken sıkça karşılaşılan teknik terimler
PEFT—parameter efficient finetuning (parametre verimli ince ayar) kısaltmasıdır ve bir LLM’nin tüm parametreleri değiştirilmeden güncellenmesi için kullanılan yöntem kategorisidir. Bu, tüm modeli uyarlamak için gereken hesaplama kaynaklarının eksik olduğu durumlarda faydalıdır.
LoRA—low-rank adaptation (düşük ranklı uyarlama) kısaltmasıdır ve yaygın bir PEFT yöntemidir [ 59 ].
Prompting—kullanıcı veya model geliştiricisi tarafından model üretim sürecine başlamadan önce modele verilen başlangıç girdisidir. Prompt verilmemiş bir LLM’ye yalnızca metin üretmeye başlamasını belirten bir “dizinin başı” (start-of-sequence) tokeni verilir. Çift yönlü sohbetlerde, kullanıcının sırası modele beslenen prompttur ve muhtemelen modelin ve kullanıcının önceki tüm yanıtlarıyla zenginleştirilir. Uygulamada, model sağlayıcıları genellikle çıktyı yönlendirmeye ve istenmeyen yanıtlara karşı korumaya yardımcı ek prompt’larla tüm girdileri modellerine sararlar.
İşlem temelli ince ayar (Instruction finetuning)—bir LLM’nin ayrıntılı belirtimlere göre yanıt verecek şekilde ince ayarının yapıldığı süreçtir. İşlem (instruction), prompt’un (girdi) yalnızca bir parçasıdır. Bu tür eğitim yoluyla model, prompt’larına dahil edilen işlemleri tanımayı ve buna göre yanıtlamayı öğrenir.
Bağlam içi öğrenme (In-context learning)—bir LLM’nin bir görevi anında, yani ek eğitim olmadan [ 60 ] nasıl yerine getireceğinin öğretildiği süreçtir. Bu, prompt’un bir parçası olarak birkaç örnek (ayrıca few-shot learning / az örnekli öğrenme olarak bilinir) sağlanarak veya görev betimlenerek (ayrıca zero-shot learning / sıfır örnekli öğrenme olarak bilinir) gerçekleştirilebilir.
RLHF—reinforcement learning from human feedback (insan geri bildirimiyle pekiştirmeli öğrenme) kısaltmasıdır ve model yanıtlarını insan etiketçilerden elde edilen tercihlere göre sıralayan bir eğitim paradigmadır [ 61 ].
Özet
Anahtar kelimeler
Yapay zekâ, klinik psikoloji, dijital psikoloji, büyük dil modelleri, mental sağlık
Atıf
Triantafyllopoulos A, Terhorst Y, Tsangko I, Pokorny FB, Bartl-Pokorny KD, Seizer L, Klein A, Chim J, Atzil-Slonim D, Liakata M, Bühner M, Löchner J ve Schuller B (2026) Mental sağlık için büyük dil modelleri. Front. Digit. Health 8:1901454. doi: 10.3389/fdgth.2026.1901454
Müracaat tarihi
05 Haziran 2026
Güncelleme tarihi
06 Ağustos 2026
Kabul tarihi
10 Ağustos 2026
Yayınlanma tarihi
12 Kasım 2026
8 – 2026
Ariel Soares Teles, Maranhão Federal Eğitim, Bilim ve Teknoloji Enstitüsü, Brezilya
Parisa Gazerani, Oslo Metropolitan Üniversitesi, Norveç
Yang Lu, Pekin Teknoloji ve İşletme Üniversitesi, Çin
© 2026 Triantafyllopoulos, Terhorst, Tsangko, Pokorny, Bartl-Pokorny, Seizer, Klein, Chim, Atzil-Slonim, Liakata, Bühner, Löchner ve Schuller.
Bu, Creative Commons Atıf Lisansı (CC BY) koşulları altında dağıtılan açık erişimli bir makaledir. Yerleşik akademik uygulamalar doğrultusunda, orijinal yazar(lar)ın ve telif hakkı sahib(lar)ının belirtilmesi ve bu dergideki orijinal yayının atıf edilmesi şartıyla, diğer platformlarda kullanım, dağıtım veya çoğaltma izinlidir. Bu koşullara uymayan herhangi bir kullanım, dağıtım veya çoğaltma izinlidir.
*İletişim: Andreas Triantafyllopoulos, andreas.triantafyllopoulos@tum.de
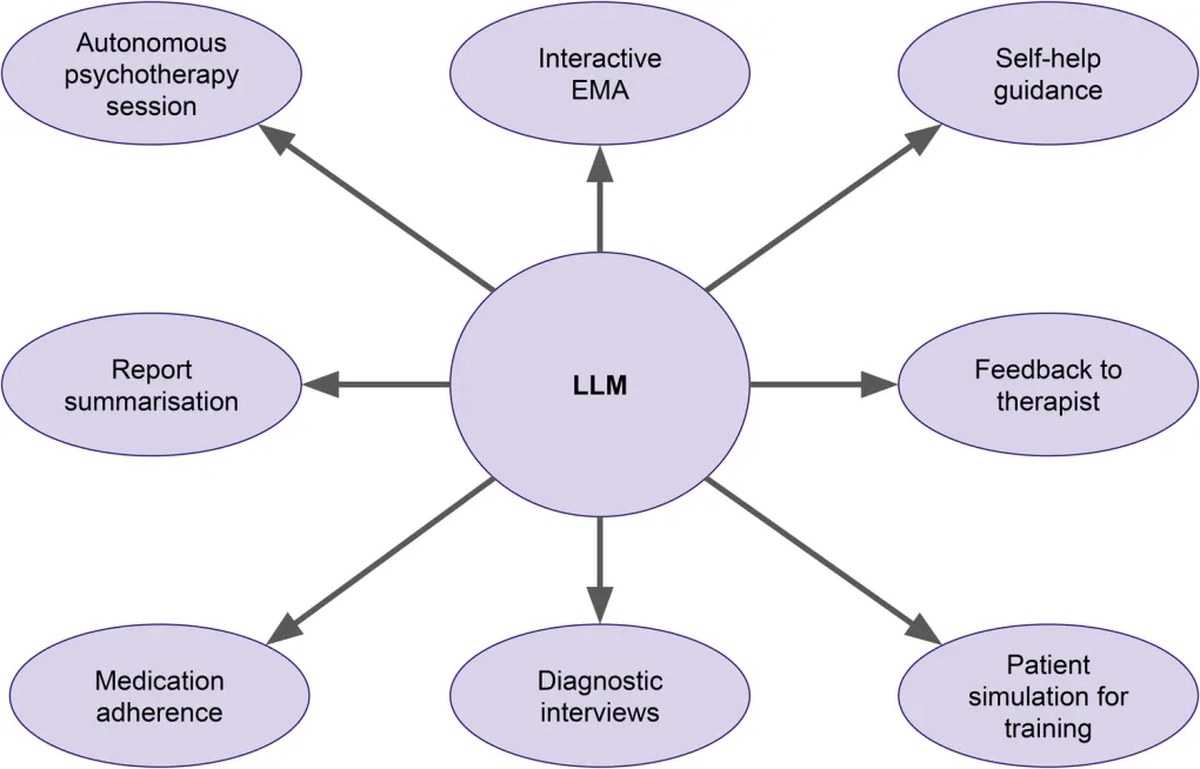
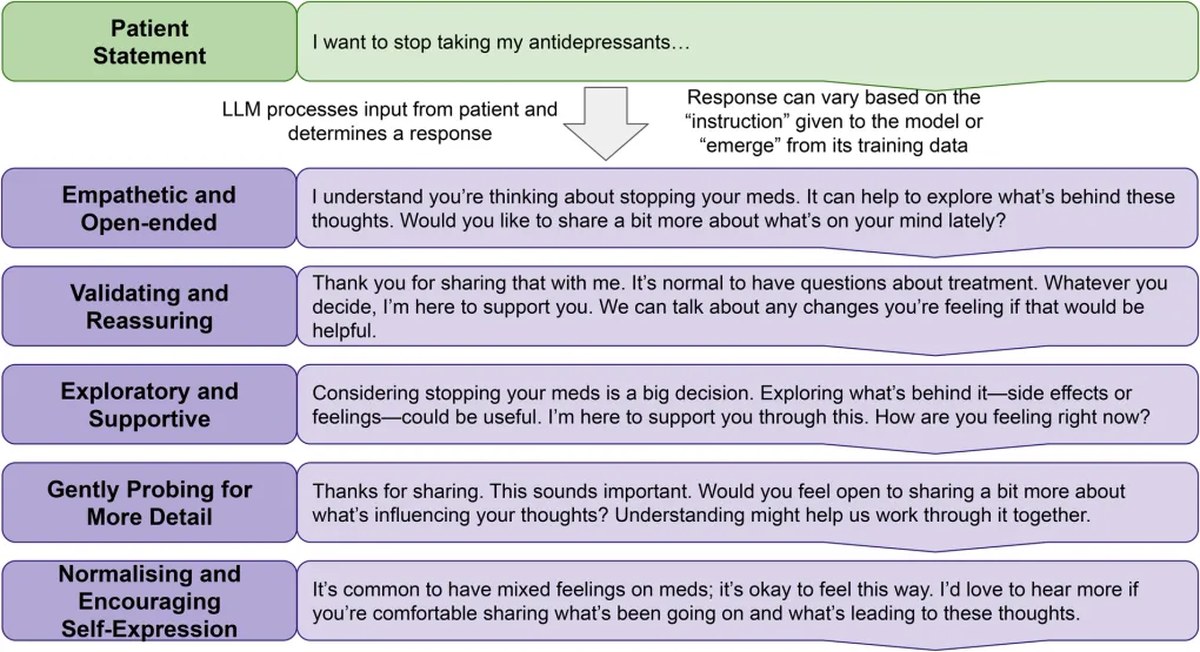
Bu makalede ifade edilen tüm iddialar yalnızca yazarlara aittir ve bağlı oldukları kuruluşların, ya da yayıncının, editörlerin ve değerlendirenlerin görüşlerini kesin olarak yansıtmaz. Bu makalede değerlendirilen veya üreticisi tarafından öne sürülebilen herhangi bir ürün, yayıncı tarafından garanti edilmez veya desteklenmez.